A inteligência artificial deixou de ser assunto de laboratório e virou prioridade de contratação em empresas de tecnologia, bancos, hospitais, indústrias, retalho, logística e consultoras. Isso abriu um mercado enorme, mas também criou uma confusão danada. Há vagas com nomes parecidos que exigem competências bem diferentes. Há empresas a pedir “AI Engineer” quando, na prática, querem um backend engineer com experiência em APIs de modelos. E há bons candidatos a falhar porque se candidatam ao tipo de vaga errado.
Se quer trabalhar com IA, precisa de perceber uma coisa logo de início: quase nenhuma empresa contrata alguém apenas porque “gosta de inteligência artificial”. O que contratam são pessoas capazes de resolver problemas concretos. Melhorar previsões de procura. Automatizar análise documental. Reduzir fraude. Criar um assistente interno que realmente funcione. Fazer recomendação de produtos sem destruir a experiência do utilizador. É isso que paga salários altos. Hype por si só não paga folha salarial.
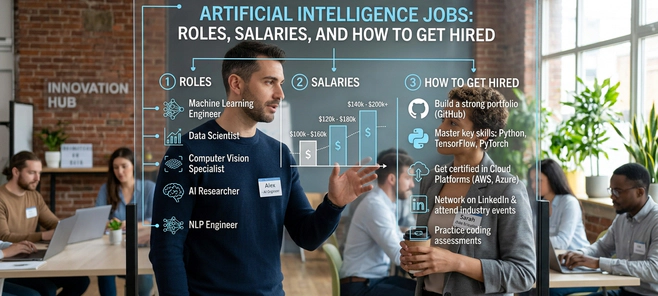
Este guia organiza o mercado de empregos em inteligência artificial de forma prática. Vai ver as funções mais comuns, diferenças entre cargos, faixas salariais, o que muda em cada nível de experiência, o que as empresas realmente avaliam e como montar uma candidatura que faça sentido. Também trago uma perspetiva mais realista para quem está em Portugal, no Brasil ou quer competir por vagas remotas internacionais.
O que conta, afinal, como emprego em inteligência artificial?
Nem toda vaga com “AI” no título é altamente técnica. E nem toda vaga altamente técnica usa as palavras “inteligência artificial”. Muita gente perde boas oportunidades por causa disso. Há funções em engenharia, análise de dados, produto, operações, investigação e infraestrutura que fazem parte do mercado de IA, mesmo sem esse rótulo na capa.
Os títulos mais comuns incluem:
- Engenheiro de Machine Learning
- Engenheiro de IA
- Cientista de Dados
- Cientista Aplicado
- Cientista de Investigação
- Engenheiro de NLP ou LLM
- Engenheiro de Visão Computacional
- Engenheiro de MLOps
- Product Manager de IA
- Engenheiro de Dados com foco em equipas de IA
Há ainda funções menos óbvias que cresceram muito desde 2023, como AI Solutions Architect, AI QA Analyst, Prompt Engineer, AI Safety Specialist, Evaluation Engineer e especialistas em data annotation operations. Nem todas são glamorosas, mas muitas servem como porta de entrada para quem ainda não tem anos de experiência em modelação.
Segundo o U.S. Bureau of Labor Statistics, uma das melhores referências públicas para tendências de contratação em tecnologia, a procura por data scientists deverá crescer 35% entre 2025 e 2035, enquanto computer and information research scientists devem crescer 22% no mesmo período. São números muito acima da média de outras profissões. Pode consultar os dados diretamente no BLS para Data Scientists e no BLS para Computer and Information Research Scientists.
A leitura correta desses números não é “toda a gente vai ficar rica com IA”. A leitura correta é outra: empresas vão continuar a contratar pessoas que consigam transformar dados, modelos e automação em resultado operacional.
As funções de IA mais comuns, sem rodeios
Títulos parecidos enganam. Na prática, o dia a dia muda bastante. Se escolher mal, vai candidatar-se a vagas desalinhadas com o seu perfil e desperdiçar semanas.
Engenheiro de Machine Learning
É uma das funções mais valorizadas do mercado. Costuma estar mais perto da engenharia de software do que da análise pura. O foco está em treinar, testar, colocar modelos em produção, monitorizar desempenho, tratar versionamento, automatizar pipelines e garantir que tudo aguenta escala.
Quem contrata para este cargo costuma procurar competências como Python forte, SQL, PyTorch ou TensorFlow, APIs, Docker, Kubernetes, cloud, CI/CD e boas práticas de software. Um engenheiro de machine learning que só sabe treinar modelos em notebook, mas não sabe meter nada a funcionar em produção, fica curto para muitas empresas.
Engenheiro de IA
Este título ficou mais amplo com a explosão da IA generativa. Em algumas empresas, é sinónimo quase direto de ML Engineer. Noutras, significa alguém que integra modelos fundacionais em produtos, constrói sistemas com RAG, orquestra chamadas a APIs, define avaliação de respostas, desenha fluxos de prompts e trata de segurança, custo e latência.
Aqui mora uma armadilha frequente. Há vagas de AI Engineer que são, na verdade, backend com OpenAI, Anthropic ou modelos open source por cima. Há outras que pedem compreensão séria de embeddings, fine-tuning, ranking, chunking, retrieval e avaliação. Ler a descrição com atenção vale mais do que acreditar no título.
Cientista de Dados
O cientista de dados tende a passar mais tempo em análise, experimentação, métricas de negócio, previsão, segmentação, testes A/B e comunicação com stakeholders. Algumas vagas incluem machine learning em produção, mas muitas estão mais ligadas a decisão e insight do que a sistemas de IA em larga escala.
É uma excelente porta de entrada para quem vem de analytics, estatística, economia, engenharia ou BI. Também é um ótimo caminho para transitar gradualmente para IA, porque obriga a construir raciocínio quantitativo e maturidade de negócio, duas coisas que faltam a muitos candidatos “apaixonados por modelos”.
Cientista Aplicado
Pense nesta função como a ponte entre investigação e produto. O cientista aplicado testa abordagens, melhora modelos, compara arquiteturas, cria métricas, avalia impacto e resolve problemas técnicos menos triviais. Costuma ter mais profundidade algorítmica do que um ML Engineer típico e mais compromisso com entrega do que um investigador puro.
Empresas grandes usam bastante este título, sobretudo em recomendação, busca, ranking, personalização, fraude, pricing e linguagem. Em Portugal e no Brasil, o nome aparece menos, mas o trabalho existe. Às vezes vem disfarçado de “Senior Data Scientist” ou “ML Scientist”.
Cientista de Investigação
Aqui a barra sobe. É a função mais académica entre os títulos comuns de IA. Muitas empresas pedem doutoramento, publicações, histórico de investigação relevante ou experiência forte em laboratórios de I&D. Aparece em centros de investigação, big techs, empresas de defesa, saúde avançada e laboratórios focados em modelos de fronteira.
Não é o caminho padrão da maioria dos profissionais. Muita gente imagina que a carreira em IA passa obrigatoriamente por investigação. Não passa. A maior parte das vagas está em aplicação, engenharia e produto.
Engenheiro de NLP, LLM ou IA Generativa
São cargos focados em sistemas de linguagem: pesquisa semântica, sumarização, extração de informação, agentes conversacionais, análise documental, classificação de texto, copilots internos e pipelines de RAG. Desde 2023, estas vagas dispararam. Também atraíram muita gente mal preparada.
As empresas mais sérias pedem Python, PyTorch, Transformers, embeddings, bases vetoriais, pipelines de avaliação, observabilidade, engenharia de prompts, noções de custo por token, técnicas de grounding e estratégias para reduzir alucinações. Ter criado um chatbot de fim de semana não impressiona quase ninguém. O que impressiona é mostrar avaliação, melhoria iterativa e entendimento de limitações reais.
Engenheiro de Visão Computacional
Foca-se em imagem e vídeo. Classificação, deteção, OCR, segmentação, inspeção de qualidade, sistemas autónomos, análise médica e monitorização industrial entram aqui. É uma área forte em indústria, saúde, retalho, automóvel, agricultura e segurança.
Quem vem desta área costuma trabalhar com OpenCV, PyTorch, modelos de deteção, pipelines de dados visuais e preocupações de latência em edge ou cloud. Bons profissionais de visão computacional continuam escassos, sobretudo quando juntam conhecimento do domínio.
Engenheiro de MLOps
É uma das funções mais subestimadas do mercado. Sem MLOps, muita iniciativa de IA vira prova de conceito eterna. Esse profissional cuida de automação de treino, versionamento, reprodutibilidade, monitorização, deploy, feature stores, escalabilidade de inferência, governação e fiabilidade.
Não recebe o mesmo brilho de um cargo com “Generative AI” no nome, mas é dos perfis mais úteis para empresas que querem sair do PowerPoint e colocar modelos a render. Quem tem base forte em DevOps, plataforma e cloud pode fazer uma transição inteligente para aqui.
Product Manager de IA
Nem toda carreira em IA passa por código. O product manager de IA define casos de uso, prioriza roadmap, alinha equipas técnicas e de negócio, mede impacto, trata dependências com jurídico e compliance e evita que a empresa construa “uma demo gira” sem valor económico.
Bons PMs de IA conseguem fazer perguntas difíceis. O modelo melhora mesmo a experiência? O risco regulatório é aceitável? Há dados suficientes? Dá para medir qualidade? Vale o custo de inferência? Em muitas equipas, esta função separa projetos úteis de desperdício caro.
Empregos em IA por nível de experiência
Este ponto costuma ser tratado de forma superficial, mas faz toda a diferença. O mercado não avalia um perfil júnior da mesma maneira que avalia alguém com cinco ou oito anos de experiência.
Vagas júnior ou de entrada
Sim, existem. Mas são menos abundantes do que vídeos motivacionais fazem parecer. As portas de entrada mais comuns são: Junior Data Scientist, Data Analyst com exposição a machine learning, Associate ML Engineer, AI QA Analyst, Annotation Operations Specialist, Junior Software Engineer em plataforma de ML e funções de avaliação de modelos.
Normalmente, as empresas esperam:
- Python e SQL sólidos
- Estatística básica e compreensão de métricas como precision, recall, F1, RMSE ou AUC, conforme o caso
- Familiaridade com pandas, scikit-learn e notebooks
- Entre 2 e 4 projetos de portefólio realmente bem feitos
- Alguma prova de que sabe trabalhar com dados imperfeitos
- Comunicação clara sobre resultados, limites e trade-offs
O erro clássico do candidato júnior é apresentar um projeto bonito e vazio. Interface gira, zero avaliação, zero contexto, zero comparação com baseline. Isso não convence. Um projeto simples, mas bem documentado, com objetivo claro, dados confusos tratados com critério, metodologia explicada e resultados medidos, vale muito mais.
Vagas de nível intermédio
Aqui entra quem tem, em geral, de 2 a 5 anos de experiência relevante. Já não basta ajudar. Espera-se autonomia. Os títulos mais comuns são ML Engineer, AI Engineer, Data Scientist II, NLP Engineer, Computer Vision Engineer e MLOps Engineer.
Neste nível, precisa de mostrar capacidade de entregar trabalho ponta a ponta. Definir o problema, preparar dados, escolher método, avaliar com senso crítico, pôr em produção algo útil e explicar limitações a pessoas não técnicas. É aqui que muitos processos concentram contratações, porque as empresas querem gente que produza rápido sem exigir pacote executivo.
Vagas sénior
O nível sénior costuma começar entre 5 e 8 anos de experiência relevante, embora haja inflação de títulos por todo o lado. Um Senior ML Engineer, Senior Applied Scientist, Staff AI Engineer ou Principal Data Scientist precisa de influenciar arquitetura, orientar colegas, elevar padrões técnicos e fazer escolhas difíceis sob incerteza.
Nesta fase, especialização de domínio pesa muito. Um profissional de IA que entende fraude bancária, fluxo clínico hospitalar, risco de crédito, pricing de retalho ou cadeia de abastecimento pode valer mais do que alguém tecnicamente mais brilhante, mas generalista. Empresas compram contexto, não apenas código.
Liderança em IA
Diretor de IA, Head of Machine Learning, VP of AI, Chief Data Scientist ou Chief AI Officer já estão noutra conversa. O trabalho deixa de ser modelar no dia a dia e passa a ser desenhar equipa, orçamento, governação, estratégia de plataforma, seleção de fornecedores, contratação e ligação entre investimento em IA e resultado financeiro.
Esses cargos não vão automaticamente para o melhor programador da sala. Vão para quem toma decisões técnicas alinhadas ao negócio, gere risco e constrói equipas que entregam. Parece óbvio, mas muita gente excelente tecnicamente falha nessa transição.
Salários em inteligência artificial
Salários em IA variam muito por país, setor, senioridade, produto, regime remoto e componente variável. Um banco tradicional paga de forma diferente de uma startup financiada. Uma multinacional americana com equipa remota em Lisboa paga diferente de uma software house local. E cargos com equity distorcem bastante a comparação.
Ainda assim, dá para trabalhar com faixas úteis. Abaixo estão intervalos indicativos de mercado, combinando referências de anúncios públicos, plataformas salariais e práticas de contratação observadas no setor. Não servem como verdade absoluta, mas ajudam bastante numa negociação.
Faixas salariais nos Estados Unidos
- Vagas de entrada em IA ou ML, entre 85.000 e 125.000 dólares base por ano
- ML Engineer ou AI Engineer de nível intermédio, entre 125.000 e 180.000 dólares base
- Perfis sénior de IA ou cientista aplicado, entre 170.000 e 240.000 dólares base
- Staff, principal e funções muito especializadas em LLM, entre 220.000 e 320.000 dólares base, podendo passar disso em big tech ou laboratórios de ponta
- Product Managers de IA em empresas fortes de produto, muitas vezes entre 160.000 e 260.000 dólares base, com bónus e ações à parte
Em empresas como Meta, Google, Amazon, OpenAI, Anthropic ou startups muito bem financiadas, a compensação total pode ser muito superior por causa de ações e bónus. A base salarial sozinha conta apenas parte da história.
Faixas salariais em Portugal
O mercado português paga menos do que o americano, isso é evidente. Mas também melhorou bastante nos últimos anos, sobretudo em multinacionais, centros de engenharia e empresas SaaS com operação internacional. Faixas realistas, em bruto anual, costumam cair mais ou menos aqui:
- Júnior em dados ou ML, entre 22.000 e 35.000 euros
- Intermédio, entre 35.000 e 55.000 euros
- Sénior, entre 50.000 e 80.000 euros
- Staff, lead ou principal em empresas internacionais, entre 75.000 e 110.000 euros, às vezes mais com bónus
Lisboa e Porto concentram a maioria das oportunidades. Fintech, telecom, consultoria tecnológica, saúde digital e centros de produto costumam pagar melhor. Startups portuguesas pequenas, por outro lado, muitas vezes querem “um especialista em IA” por um salário de analista sénior. Convém filtrar cedo.
Faixas salariais no Brasil
No Brasil, a dispersão é grande. Há diferença brutal entre empresa nacional tradicional, startup em crescimento e contratação dolarizada para o exterior. De forma simplificada:
- Perfis de entrada em dados e ML, entre 5.000 e 9.000 reais por mês
- Intermédio, entre 9.000 e 16.000 reais por mês
- Sénior, entre 16.000 e 28.000 reais por mês
- Especialistas e liderança, acima de 30.000 reais por mês, com casos bem acima disso em fintechs e empresas globais
Quem consegue trabalhar remotamente para empresas dos EUA ou da Europa pode multiplicar esses números. Só que a concorrência também sobe muito. Inglês profissional deixa de ser diferencial e vira requisito básico.
Trabalho remoto em IA, ainda vale a pena?
Vale, mas já não é a festa de 2021. Muitas empresas passaram para modelos híbridos, especialmente quando lidam com dados sensíveis, hardware especializado ou equipas de produto muito integradas. Ainda assim, IA continua entre as áreas com melhor volume de vagas remotas internacionais.
As funções com mais probabilidade de remoto total costumam ser:
- Engenheiro de IA focado em APIs, integrações e produtos SaaS
- Engenheiro de NLP ou LLM
- Cientista de dados com foco em experimentação e analytics
- MLOps Engineer em equipas distribuídas
- Product Manager de IA em empresas digitais
Já funções com laboratório físico, dados restritos, hardware ou forte dependência de equipas locais tendem a ser mais presenciais. Visão computacional para manufatura e investigação aplicada em saúde são exemplos típicos.
Se está a mirar remoto internacional, aceite isto: o nível de exigência sobe. O recrutador recebe currículos de três continentes. Nessa arena, GitHub desorganizado, LinkedIn genérico e inglês fraco custam caro.
O que as empresas realmente procuram
Há muito ruído no mercado. Entre a fantasia de “substituir tudo com IA” e a realidade operacional, as empresas sérias tendem a procurar cinco coisas.
1. Capacidade de resolver um problema concreto
A empresa não quer apenas alguém que saiba nomes de modelos. Quer alguém que entenda o problema, escolha a abordagem adequada e prove que ela melhora algum indicador. Receita, tempo, custo, qualidade, precisão, retenção, produtividade. Alguma coisa precisa mexer.
2. Base técnica suficiente para o tipo de vaga
Parece banal, mas muita candidatura cai aqui. Para engenharia, Python limpo, APIs, testes, cloud e estruturas de dados contam bastante. Para ciência de dados, estatística, experimentação e modelação importam mais. Para LLM, avaliação e arquitetura de aplicação são decisivas.
3. Entendimento de produção
Modelos em slide não geram valor. Empresas adoram candidatos que percebem monitorização, latência, custo de inferência, drift, versionamento, logging, fallback e segurança. Mesmo para vagas menos seniores, demonstrar noção de produção diferencia muito.
4. Comunicação decente
Nem sempre ganha o mais brilhante tecnicamente. Ganha muitas vezes quem explica melhor, pergunta melhor e traduz melhor a tecnologia para impacto de negócio. Especialmente em IA, onde há bastante risco de prometer demais.
5. Julgamento
Julgamento técnico e profissional. Saber quando um modelo simples basta. Saber quando não há dados suficientes. Saber dizer não a uma ideia má. Saber reconhecer risco ético, legal ou operacional. Isto pesa mais do que parece.
Como entrar na área de IA sem perder tempo
Há mais de um caminho viável. O melhor depende do seu ponto de partida.
Se vem de engenharia de software
Tem uma vantagem enorme. Já sabe construir sistemas, lidar com código real e pensar em produção. O passo natural costuma ser aprender Python para dados, bibliotecas de ML, fundamentos de modelação, avaliação e ferramentas de deploy. Gente com base forte de engenharia consegue migrar para ML Engineer, AI Engineer e MLOps com boa velocidade.
Se vem de análise de dados, BI ou estatística
O caminho mais lógico é avançar por Data Science e depois especializar. Falta muitas vezes engenharia de software e prática de produção, mas sobra sensibilidade analítica. Complete a lacuna técnica com projetos mais completos, versionamento, APIs e alguma cloud. Funciona muito bem.
Se vem de academia ou investigação
Tem profundidade teórica, o que ajuda bastante em funções aplicadas mais complexas. O risco é parecer demasiado distante de prazos, produto e negócio. Para reduzir essa barreira, mostre projetos com entrega, colaboração e foco em aplicação. Não assuma que o recrutador ficará impressionado apenas pelo tema da dissertação.
Se está a começar do zero
Dá para entrar, mas convém controlar expectativas. Aprender IA do zero até um nível empregável não costuma ser projeto de 8 semanas. Para a maioria das pessoas, estamos a falar de 6 a 18 meses de estudo consistente, dependendo da base anterior. Menos promessa de curso milagroso, mais prática séria.
Um portefólio que ajuda mesmo
Portefólio bom não é coleção de notebooks largados. Também não é copiar tutorial do YouTube e trocar o dataset. O que funciona é mostrar raciocínio, execução e maturidade.
Um portefólio forte para IA costuma ter:
- Um problema bem definido e relevante
- Dados reais ou, no mínimo, dados imperfeitos o suficiente para exigir tratamento
- Comparação entre abordagens, inclusive baseline simples
- Métricas apropriadas ao problema
- Explicação de trade-offs, limitações e riscos
- Código organizado, README útil e instruções para reproduzir
- Se possível, uma demo funcional ou API básica
Três projetos bons chegam mais longe do que dez medianos. Por exemplo: um sistema de classificação documental com OCR e avaliação séria, um pipeline de previsão com monitorização de drift, e uma aplicação de RAG com comparação entre estratégias de retrieval. Isso já conta uma história profissional muito melhor.
Certificações, cursos e mestrado, valem a pena?
Valem, às vezes. Mas ninguém é contratado só porque acumulou crachás.
Certificações em cloud, dados ou machine learning podem ajudar bastante quando reforçam uma base real. AWS, Google Cloud e Azure têm certificações úteis para quem mira MLOps, engenharia de dados e deploy de modelos. Cursos bons também aceleram aprendizagem, desde que não substituam prática.
Mestrado pode ser uma ótima aposta para quem quer profundidade técnica, transição mais estruturada ou acesso a redes académicas e empresariais. Mas não é obrigatório para a maioria das vagas aplicadas. Doutoramento tende a fazer mais sentido para investigação, ciência aplicada avançada e alguns contextos muito especializados.
Resumo honesto: curso ajuda, certificação ajuda, pós-graduação ajuda. Nada disso salva um candidato sem portefólio, sem clareza técnica e sem capacidade de explicar o que fez.
Como adaptar o currículo para vagas de IA
Currículo genérico mata candidatura. Em IA, isso acontece ainda mais porque o recrutador tenta descobrir em poucos segundos se você é engenharia, ciência, analytics ou produto. Se o documento mistura tudo sem foco, perde força.
Boas práticas:
- Ajuste o título profissional ao tipo de vaga
- Destaque stack relevante, não uma lista infinita de buzzwords
- Descreva impacto com números sempre que possível
- Mostre contexto do problema e resultado entregue
- Inclua links para GitHub, portefólio ou publicações, se estiverem arrumados
- Evite exageros como “especialista em IA” sem histórico que sustente isso
Em vez de escrever “Desenvolvimento de soluções de inteligência artificial”, escreva algo como “Implementei pipeline de classificação de tickets com BERT, reduzindo o tempo médio de triagem em 37%”. Isto fala a língua do recrutamento.
O que costuma cair nas entrevistas
O processo varia por empresa, mas há padrões bem repetidos.
Para engenharia de IA e ML
Espere perguntas sobre Python, estruturas de dados, SQL, design de sistemas, APIs, deploy, monitorização, pipelines de treino, features, avaliação de modelos, escalabilidade e incidentes em produção. Para LLM, podem entrar temas como embeddings, chunking, retrieval, fine-tuning, guardrails e custo.
Para ciência de dados
É comum aparecer estatística, inferência, experimentação, métricas, limpeza de dados, modelação, validação, explicação de resultados e estudo de caso de negócio. Menos glamour de framework, mais clareza de raciocínio.
Para produto em IA
A conversa gira em torno de priorização, casos de uso, riscos, métricas, alinhamento com jurídico, experiência do utilizador, fiabilidade e retorno esperado. Um bom PM de IA precisa de saber dizer por que não construir algo, não apenas defender por que construir.
Erros que afastam bons candidatos
Vejo alguns padrões repetidos.
- Candidatar-se a todo tipo de vaga com o mesmo currículo
- Confundir demo com produto
- Falar muito de ferramentas e pouco de resultados
- Ignorar fundamentos de estatística e avaliação
- Subestimar comunicação
- Não estudar o domínio da empresa
- Fingir senioridade que ainda não tem
Este último ponto merece honestidade. O mercado até tolera lacunas. O que raramente tolera é pose. Alguém que se vende como especialista em LLM e não sabe explicar precision versus recall, ou não entende avaliação offline, vai ser apanhado rápido.
Setores que mais contratam profissionais de IA
Nem toda oportunidade está em big tech. Aliás, uma parte muito interessante do mercado está fora dela.
Os setores com procura consistente incluem:
- Software SaaS e empresas de produto digital
- Banca, seguros e fintech
- Saúde, healthtech e dispositivos médicos
- Retalho e e-commerce
- Indústria e manufatura
- Logística e supply chain
- Cibersegurança
- Telecomunicações
- Consultoria tecnológica
- Defesa e setor público avançado
Fraude, pricing, previsão de procura, recomendação, automação documental, atendimento assistido, manutenção preditiva e otimização operacional continuam entre os casos de uso que mais geram contratação real.
Vale a pena apostar numa carreira em inteligência artificial?
Sim, vale. Mas com os pés no chão. IA é uma área excelente para quem gosta de resolver problemas difíceis, aprender rápido e trabalhar na fronteira entre tecnologia e negócio. Também é uma área exigente, competitiva e cheia de exagero marketing.
A melhor estratégia não é tentar parecer génio. É ficar útil. Escolha um caminho claro, construa base técnica séria, monte projetos que provem capacidade real, aprenda a comunicar impacto e candidate-se com foco. Quem faz isso não depende da moda do momento. Continua contratável mesmo quando o mercado filtra o barulho.
Se eu tivesse de resumir tudo numa frase, seria esta: empresas contratam profissionais de IA para entregar resultado, não para repetir buzzwords. Quem entender isso sai na frente.