Sztuczna inteligencja przestała być tematem z konferencji dla doktorantów i laboratoriów badawczych. Dziś rekrutują banki, software house’y, firmy medyczne, e-commerce, logistyka, produkcja, cyberbezpieczeństwo i sektor publiczny. Problem polega na tym, że kandydaci często widzą modny skrót „AI”, ale nie wiedzą, co realnie kryje się pod konkretną ofertą. A to robi ogromną różnicę.
Pracodawcy rzadko szukają po prostu „specjalisty od AI”. Szukają ludzi, którzy umieją rozwiązać konkretny problem. Jedna firma potrzebuje machine learning engineera, który wdroży model do produkcji i ogarnie monitoring. Inna chce data scientista, który poprawi retencję klientów i policzy wpływ zmian na biznes. Jeszcze inna zatrudnia AI Product Managera, bo wdrożenie modelu bez sensownego use case’u kończy się spaleniem budżetu.
Ten przewodnik porządkuje temat od A do Z. Znajdziesz tu najważniejsze role w AI, różnice między nimi, widełki wynagrodzeń, wymagania dla juniorów i seniorów, trendy zdalne, przykłady technologii, a przede wszystkim praktyczny plan działania. Nie teorię. Rzeczy, które faktycznie pomagają dostać pracę.
Co właściwie liczy się jako praca w AI?
Nie każda oferta z „AI” w nazwie jest mocno techniczna. I odwrotnie, wiele bardzo technicznych ról wcale nie ma tego skrótu w tytule. W polskich i europejskich ogłoszeniach równie często zobaczysz nazwy związane z machine learningiem, data science, automatyzacją, analityką predykcyjną albo generative AI.
To ważne, bo kandydaci często zawężają wyszukiwanie do kilku modnych słów kluczowych, a przez to omijają dobre oferty. Jeśli wpisujesz tylko „AI Engineer”, możesz przegapić ogłoszenia pod tytułem „ML Engineer”, „Applied Scientist”, „NLP Specialist”, „Data Scientist”, „MLOps Engineer” albo „Software Engineer, ML Platform”.
Najczęstsze stanowiska związane z AI to:
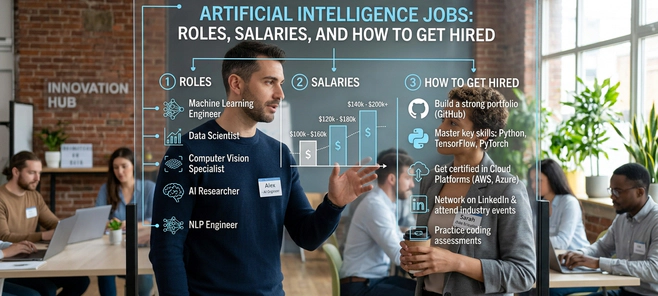
- Machine Learning Engineer
- AI Engineer
- Data Scientist
- Applied Scientist
- Research Scientist
- NLP Engineer lub LLM Engineer
- Computer Vision Engineer
- MLOps Engineer
- AI Product Manager
- Data Engineer wspierający zespoły AI
- AI Adoption Lead
- AI Enablement Specialist lub Copilot Enablement Lead
- AIOps Engineer
- Agentic SDLC Engineer
- AI Platform Engineer lub Inference Platform Engineer
Skala wzrostu tego rynku nie jest wymysłem LinkedIna. Według amerykańskiego Bureau of Labor Statistics zawód data scientist ma rosnąć o 35% w latach 2025-2035, a computer and information research scientist o 22% w tym samym okresie. To dane z rynku USA, ale trend jest szerszy. Europa i Polska też przyspieszyły, szczególnie po 2023 roku, gdy generatywna AI weszła do mainstreamu i przestała być dodatkiem do prezentacji zarządu. BLS, Data Scientists, BLS, Computer and Information Research Scientists
Na polskim rynku widać to już nie tylko po raportach, ale po samych ogłoszeniach. W typowym przeglądzie dużych agregatorów i portali branżowych z jednego tygodnia w 2025 roku da się znaleźć zwykle od kilkuset do ponad tysiąca aktywnych ofert powiązanych z AI, ML, data science i generative AI, zależnie od tego, czy liczysz tylko Polskę, czy także role remote dla kandydatów z Polski. Sam segment stricte AI i ML, po odfiltrowaniu analityki BI i klasycznego data engineeringu, daje często kilkadziesiąt do ponad 200 świeżych ogłoszeń jednocześnie. To nie jest nisza kolekcjonerska. To już normalna kategoria rekrutacyjna.
W praktyce snapshot rynku wygląda mniej więcej tak: najwięcej ofert zbierają Warszawa, Kraków i Wrocław, potem Trójmiasto, Poznań i Katowice, a osobną kategorią są role remote na całą Polskę lub kontrakty dla firm z Niemiec, Holandii, Wielkiej Brytanii i USA. Jeśli w danym tygodniu widzisz 80-120 aktywnych ofert z tagami AI/ML na kilku źródłach naraz, to nie znaczy, że rynek jest mały. To znaczy, że część firm publikuje tylko na własnych stronach karier, część przez agencje, a część przez agregatory. Warto sprawdzać wszystkie trzy kanały.
Najprostsza zasada brzmi tak: firmy płacą za użyteczność, nie za hype. Jeżeli twój model poprawia sprzedaż, ogranicza fraud, skraca czas obsługi klienta, zmniejsza koszty reklamacji albo automatyzuje żmudne procesy, jesteś ciekawy dla rynku. Jeśli pokazujesz tylko kolejnego chatbota bez mierników jakości i bez sensownego wdrożenia, konkurencja szybko cię wyprzedzi.
Najpopularniejsze stanowiska w AI, czym różnią się w praktyce
Nazwy stanowisk brzmią podobnie, ale zakres odpowiedzialności potrafi być skrajnie różny. To jeden z głównych powodów, dla których kandydaci wysyłają CV na oślep i potem nie dostają odpowiedzi. Tytuł to za mało. Liczy się realny zakres pracy.
Machine Learning Engineer
To zwykle rola najbliższa klasycznemu software engineeringowi. Taka osoba buduje pipeline’y treningowe, przygotowuje deployment modeli, pisze kod produkcyjny, współpracuje z infrastrukturą chmurową i pilnuje, żeby model działał stabilnie po wdrożeniu. Nie chodzi tylko o „wytrenowanie czegoś w notebooku”. Chodzi o system, który da się utrzymać.
W praktyce pracodawcy oczekują tu najczęściej: Pythona, SQL, Git, Dockera, podstaw Kubernetes, pracy z chmurą, znajomości frameworków typu PyTorch albo TensorFlow oraz rozumienia CI/CD. Jeśli masz profil bardziej inżynierski niż analityczny, to często najlepsza ścieżka wejścia.
Na polskim rynku takie oferty regularnie pojawiają się w Allegro, Ocado Technology, Snowflake, deepsense.ai, Sii, STX Next, Samsung R&D, Aptiv, Motorola Solutions czy większych bankach budujących własne platformy danych. Typowy stack z ogłoszeń to Python, FastAPI, Docker, Kubernetes, MLflow, AWS lub GCP, Airflow, Terraform i Prometheus. Jeżeli w opisie pojawia się też Kafka, Feast, Kubeflow albo Ray, to zwykle mówimy o roli bliższej platformie ML niż klasycznemu modelowaniu.
AI Engineer
Ten tytuł zrobił się bardzo szeroki. W jednej firmie AI Engineer to praktycznie ML Engineer. W innej będzie to osoba integrująca modele językowe z produktem, budująca pipeline RAG, system promptów, warstwę ewaluacji i integracje przez API. Po boomie na LLM-y wiele ogłoszeń zaczęło używać tego tytułu niemal marketingowo, więc opis stanowiska trzeba czytać wyjątkowo uważnie.
Jeśli oferta mówi o embeddingach, vector database, retrieval, guardrails, evaluation framework, prompt optimization, function calling czy orkiestracji agentów, to zwykle jest to rola bardziej „produktowo-integracyjna” niż klasyczne modelowanie od zera.
W Polsce takie role przewijają się choćby w software house’ach robiących wdrożenia enterprise AI, w spółkach produktowych SaaS oraz w konsultingu technologicznym. W przykładowych ofertach zobaczysz zestawy typu Python, LangChain, LlamaIndex, OpenAI lub Azure OpenAI, pgvector albo Weaviate, Redis, FastAPI, Docker i Azure. Jeśli firma dopisuje Semantic Kernel, Microsoft Graph, Copilot Studio albo Power Platform, to rola jest często mocno osadzona w ekosystemie Microsoft 365 i wdrożeniach dla korporacji.
Data Scientist
Data scientist częściej pracuje na styku analizy, eksperymentów i decyzji biznesowych. Owszem, może budować modele predykcyjne, ale sporo czasu poświęca też na analizę danych, segmentację klientów, forecasting, testy A/B, wyciąganie wniosków i tłumaczenie wyników ludziom spoza zespołu technicznego.
To dobry kierunek dla osób, które mają mocne podstawy statystyki, SQL i analityki, a dopiero później chcą przejść w stronę bardziej zaawansowanego machine learningu. W Polsce wiele osób wchodzi do AI właśnie tą drogą, zaczynając od analityki danych lub BI.
Realne polskie ogłoszenia dla data scientistów pojawiają się stale w bankowości, telco, retailu i marketplace’ach. ING Hubs Poland, mBank, Orange, Żabka, Rossmann Tech, OLX, Booksy czy firmy consultingowe regularnie szukają ludzi od predykcji, rekomendacji, segmentacji i eksperymentów. Stack z takich ofert bywa mniej efektowny niż w mediach społecznościowych, ale bardzo rynkowy: SQL, Python, scikit-learn, pandas, dbt, Airflow, BigQuery, Databricks, Tableau lub Power BI.
Applied Scientist
Applied Scientist to rola między badaniami a produktem. Taka osoba eksperymentuje z modelami, poprawia jakość rozwiązań, testuje różne podejścia i pracuje nad trudnymi problemami domenowymi, ale jednocześnie funkcjonuje w rytmie produktu i terminów biznesowych.
W dużych firmach technologicznych to często bardzo ceniona ścieżka. Trzeba umieć wejść głębiej w algorytmy niż typowy ML Engineer, ale jednocześnie nie odklejać się od potrzeb użytkownika i firmy.
Research Scientist
To najbardziej akademicka z popularnych ścieżek. Pracodawcy często oczekują doktoratu, publikacji, doświadczenia badawczego i mocnego backgroundu matematycznego. Takie role spotkasz w laboratoriach badawczych, korporacyjnych działach R&D i specjalistycznych zespołach pracujących nad nowymi architekturami modeli.
Brzmi prestiżowo, ale nie jest to domyślna droga dla większości kandydatów. W polskich warunkach tych ofert jest mało, a konkurencja jest wysoka. Jeżeli twoim celem jest po prostu wejście do branży AI i zarabianie dobrze na kompetencjach technicznych, dużo szybciej dostaniesz się przez ML engineering, data science albo MLOps.
NLP Engineer, LLM Engineer, Generative AI Engineer
To obecnie jedne z najgłośniejszych stanowisk. Zakres obejmuje systemy językowe, wyszukiwarki semantyczne, podsumowania dokumentów, klasyfikację tekstu, chatboty, asystentów wewnętrznych, analizę treści, OCR wspierany przez modele językowe i pipeline’y RAG.
Pracodawcy oczekują tu zwykle Pythona, PyTorch, Hugging Face Transformers, doświadczenia z embeddingami, pracy z dokumentami, oceny jakości odpowiedzi modelu, podstaw bezpieczeństwa promptów i znajomości narzędzi takich jak LangChain, LlamaIndex czy vLLM. Samo „umiem korzystać z API OpenAI” już nie robi wrażenia. To dziś punkt startowy, nie przewaga.
W aktualnych ofertach z Polski i dla Polski często pojawiają się też konkretne kombinacje technologii: Azure AI Search plus Azure OpenAI, Elasticsearch plus reranking, Qdrant plus FastAPI, Hugging Face plus vLLM, albo OCR z Document AI i walidacją odpowiedzi przez własny moduł ewaluacyjny. To ważna wskazówka. Jeśli budujesz portfolio pod LLM-y, nie pokazuj tylko czatu. Pokaż retrieval, ocenę jakości, koszty, opóźnienia i ochronę danych.
Computer Vision Engineer
Ta ścieżka skupia się na obrazie i wideo. W praktyce oznacza to detekcję obiektów, klasyfikację, segmentację, OCR, kontrolę jakości na liniach produkcyjnych, analizę nagrań, systemy autonomiczne albo przetwarzanie obrazów medycznych.
W Polsce takie role znajdziesz m.in. w produkcji, automotive, retail tech, medtech i firmach budujących rozwiązania dla przemysłu. To nisza mniejsza niż NLP, ale zwykle stabilna i konkretna biznesowo.
MLOps Engineer
MLOps to niedoceniany, a bardzo potrzebny obszar. Tu chodzi o to, żeby cały „silnik AI” działał przewidywalnie. Reprodukowalne środowiska, deployment modeli, monitoring, observability, feature store, kontrola wersji danych, pipeline’y treningowe, governance i skala inferencji.
Szczerze mówiąc, wielu kandydatów ignoruje tę ścieżkę, bo nie brzmi tak efektownie jak LLM Engineer. To błąd. Firmy naprawdę potrzebują ludzi od MLOps, bo bez nich nawet dobry model szybko zamienia się w kosztowny bałagan.
W 2025 roku ta rola coraz częściej rozdziela się na dwie podścieżki. Pierwsza to klasyczny MLOps wokół treningu i wdrożeń. Druga to AI infrastructure i inference operations. W tych ofertach pojawiają się już nie tylko Kubernetes i MLflow, ale też GPU orchestration, OpenShift AI, NVIDIA Triton Inference Server, NVIDIA NIM, CUDA, KServe, Seldon, OpenTelemetry, Grafana, Prometheus i autoskalowanie inferencji. Jeśli widzisz w ogłoszeniu frazy typu model serving, GPU scheduling, observability for LLM workloads, token throughput, latency SLO albo multi-tenant inference, to nie jest zwykły DevOps z dopiskiem AI. To osobna specjalizacja, coraz lepiej płatna.
W Polsce takie wymagania trafiają się już w centrach R&D, większych software house’ach infrastrukturalnych, firmach przemysłowych i dostawcach platform dla enterprise. Przykładowe zestawy z realnych ogłoszeń to Red Hat OpenShift, OpenShift AI, ArgoCD, Helm, Kubeflow, NVIDIA GPU Operator, OpenTelemetry, Jaeger, Loki, Terraform i chmury hybrydowe. Kandydat, który potrafi opisać jak monitorować inferencję LLM pod kątem kosztu na 1000 zapytań, opóźnień P95 i spadku jakości odpowiedzi, jest dziś dla rynku znacznie cenniejszy niż ktoś, kto umie tylko postawić demo w notebooku.
AI Product Manager
To rola dla osób, które nie muszą codziennie trenować modeli, ale muszą rozumieć ich możliwości, ograniczenia, ryzyka prawne i sens biznesowy. AI Product Manager ustala use case’y, priorytety na roadmapie, metryki sukcesu, współpracę z legalem, designem, engineeringiem i zarządem.
Dobry PM od AI nie sprzedaje marzeń. Odcina bezsensowne pomysły, zanim zespół przepali miesiące pracy. Dla doświadczonych product managerów to bardzo sensowna ścieżka specjalizacji.
AI Adoption Lead, AI Enablement, Copilot Enablement
To kategoria, która urosła błyskawicznie po wejściu Microsoft Copilot, Google Gemini for Workspace i firmowych asystentów opartych o LLM-y. Taka osoba nie zawsze buduje model. Często odpowiada za wdrożenie AI w organizacji, szkolenia zespołów, governance, wybór use case’ów, pomiar adopcji, bezpieczeństwo danych i integrację z codzienną pracą sprzedaży, HR, operacji czy działów prawnych.
W ogłoszeniach zobaczysz nazwy typu AI Adoption Lead, GenAI Enablement Manager, Copilot Specialist, Copilot Success Manager, AI Transformation Lead albo Modern Work & AI Consultant. Typowy stack i zakres to Microsoft 365, Copilot for Microsoft 365, Copilot Studio, Power Platform, Azure OpenAI, Purview, Entra ID, polityki bezpieczeństwa, szkolenia użytkowników i KPI adopcyjne. To dobra ścieżka dla osób z backgroundem wdrożeniowym, change managementowym, IT consultingowym albo produktowym.
AIOps Engineer
AIOps bywa mylone z MLOps, ale to nie to samo. MLOps dotyczy cyklu życia modeli. AIOps zwykle koncentruje się na wykorzystaniu AI i automatyzacji do monitoringu systemów IT, analizy alertów, wykrywania anomalii, korelacji incydentów i przyspieszenia pracy zespołów SRE oraz operations.
W praktyce to role na styku observability, SRE, platform engineeringu i automatyzacji. W ofertach pojawiają się OpenTelemetry, Dynatrace, Datadog, Splunk, Elastic, ServiceNow, Python, incident correlation, event pipelines i integracje z runbookami. Dla ludzi z doświadczeniem w infrastrukturze albo produkcyjnych systemach IT to bardzo sensowna droga wejścia do AI bez zaczynania od zera.
Agentic SDLC Engineer
To jeden z nowszych tytułów i warto go śledzić, bo będzie się pojawiał coraz częściej. Chodzi o wykorzystanie agentów AI i narzędzi copilota w cyklu wytwarzania oprogramowania, od generowania kodu i testów po analizę pull requestów, dokumentacji, ticketów i automatyzację pracy zespołów developerskich.
Takie role wymagają zwykle czegoś więcej niż fascynacji agentami. Firmy szukają ludzi, którzy rozumieją SDLC, CI/CD, bezpieczeństwo kodu, polityki dostępu, jakość testów, telemetrykę i produktywność zespołów. W technologiach przewijają się GitHub Copilot, GitHub Actions, Cursor, Azure DevOps, Jira, MCP, API modeli, ocena jakości wygenerowanego kodu, guardraile i wewnętrzne workflow automation. To dobra opcja dla senior backendowców, platform engineerów i engineering managerów, którzy chcą wejść w AI od strony produktywności deweloperskiej.
Które role są najbardziej przyszłościowe w Polsce i Europie
Na naszym rynku najszybciej rosną dziś cztery grupy ról. Pierwsza to AI Engineer i LLM Engineer, bo firmy chcą szybko wprowadzać funkcje generatywne do istniejących produktów. Druga to ML Engineer i MLOps Engineer, bo po etapie eksperymentów przychodzi moment wdrożeń i porządkowania środowiska. Trzecia to Data Scientist z mocnym zrozumieniem biznesu. Czwarta to specjaliści sektorowi, na przykład AI w medycynie, fintechu, cyberbezpieczeństwie czy produkcji.
Największą przewagę mają kandydaci, którzy łączą technologię z kontekstem branżowym. Senior, który zna regulacje finansowe albo realia procesów magazynowych, bywa cenniejszy niż ktoś technicznie mocniejszy, ale kompletnie ogólny. Pracodawcy płacą za skrócenie drogi od pomysłu do wyniku.
Warto dodać piątą grupę, bardzo aktualną. Są nią role adopcyjne i enablementowe, szczególnie wokół Copilotów, agentów i wdrożeń AI do pracy biurowej oraz developerskiej. Szukają ich banki, konsulting, integratorzy Microsofta, działy transformacji cyfrowej i firmy z dużą bazą pracowników wiedzy. To nie są „miękkie” posady dla osób bez kompetencji. Dobre wdrożenie adopcji AI wymaga zrozumienia bezpieczeństwa, procesów, licencjonowania, ryzyka i realnego zachowania użytkowników.
Praca w AI według poziomu doświadczenia
To temat, który większość poradników traktuje po łebkach. Niesłusznie. Firma zupełnie inaczej ocenia juniora, mida i seniora. Inne są wymagania, inna odpowiedzialność, inny styl rozmowy rekrutacyjnej.
Stanowiska entry-level i juniorskie
Prawdziwe role juniorskie w AI istnieją, ale jest ich mniej, niż sugerują filmiki w social mediach. Najczęściej będą to stanowiska w rodzaju junior data scientist, data analyst z ekspozycją na ML, associate ML engineer, AI QA specialist, prompt evaluation analyst, annotation specialist albo software engineer w zespole platformy ML.
Na tym poziomie pracodawca zwykle oczekuje:
- solidnych podstaw Pythona i SQL
- rozumienia statystyki, walidacji modeli i metryk jakości
- znajomości pandas, scikit-learn, notebooków i pracy na danych nieidealnych
- 2-4 sensownych projektów do portfolio
- umiejętności opisania problemu biznesowego i ograniczeń rozwiązania
- komunikacji na tyle dobrej, by wytłumaczyć wyniki osobie nietechnicznej
Najczęstszy błąd juniorów? Budują prostego chatbota w weekend, wrzucają repozytorium na GitHuba i uznają temat za zamknięty. Tymczasem rekruter techniczny patrzy szerzej. Czy jest dokumentacja? Czy są dane testowe? Czy ktoś opisał metryki? Czy wiadomo, po co to rozwiązanie istnieje? Czy kod da się uruchomić bez domyślania się połowy konfiguracji?
Mid-level, czyli poziom najbardziej pożądany
Mid to zwykle 2-5 lat doświadczenia w obszarze pokrewnym lub bezpośrednio w AI. Tu firmy szukają ludzi, którzy potrafią samodzielnie dowieźć projekt od początku do końca. Nie tylko napisać model, ale też zdefiniować problem, przygotować dane, dobrać podejście, ocenić wyniki, wdrożyć rozwiązanie i uczciwie opisać jego ograniczenia.
W praktyce najwięcej rekrutacji dotyczy właśnie tego poziomu. Powód jest prosty. Tacy specjaliści dają wartość szybciej niż juniorzy, a kosztują mniej niż seniorzy. Jeśli masz już doświadczenie w backendzie, data engineeringu, analityce albo DevOps, przebranżowienie do AI na poziom mida bywa całkiem realne.
Senior AI
Poziom senior zwykle zaczyna się od około 5-8 lat sensownego doświadczenia, choć rynek ma skłonność do inflacji tytułów. Senior ML Engineer, Senior Applied Scientist czy Staff AI Engineer odpowiada nie tylko za własny kod, lecz także za architekturę, standardy techniczne, mentoring, jakość decyzji i trudne kompromisy.
Tu bardzo mocno zaczyna działać specjalizacja domenowa. Senior od AI w ochronie zdrowia, który rozumie dokumentację medyczną, prywatność danych i ryzyko modelu, bywa dla pracodawcy znacznie cenniejszy niż ogólny specjalista z bardziej efektownym CV. Tak samo jest w bankowości, logistyce, e-commerce czy cybersec.
Liderzy, dyrektorzy i head of AI
Na poziomie leadershipu codzienna praca coraz mniej przypomina modelowanie. Pojawia się projektowanie zespołu, hiring, budżety, governance, dobór vendorów, standardy bezpieczeństwa, zgodność z regulacjami, zarządzanie ryzykiem i łączenie inwestycji w AI z wynikiem finansowym firmy.
Takie role nie trafiają automatycznie do najlepszego programisty w zespole. Wygrywają ludzie, którzy umieją podejmować decyzje przy niepewności, priorytetyzować i budować zespół dowożący wynik, a nie slajdy.
Zarobki w AI, ile można zarobić w Polsce i za granicą
Temat wynagrodzeń budzi najwięcej emocji i niestety też najwięcej mitów. W AI tytuły stanowisk się nakładają, a widełki potrafią różnić się drastycznie zależnie od kraju, formy współpracy, branży, poziomu seniority i tego, czy mówimy o startupie, software housie czy globalnej korporacji.
Podawanie jednej „średniej pensji w AI” nie ma większego sensu. Lepiej patrzeć na konkretne segmenty rynku. Poniżej znajdziesz realne, orientacyjne przedziały, które dobrze oddają obecne warunki rekrutacyjne z 2025 i 2026 roku. To nie są gwarantowane stawki dla każdego, ale sensowny punkt odniesienia.
Polska, umowa o pracę, orientacyjne widełki miesięczne brutto
- Junior Data Scientist lub Junior ML Engineer: 9 000-15 000 zł
- Mid Data Scientist, ML Engineer, AI Engineer: 16 000-27 000 zł
- Senior ML Engineer, Senior AI Engineer, Applied Scientist: 28 000-40 000 zł
- Staff, Principal, Lead AI: 38 000-55 000 zł i więcej
- AI Product Manager: 20 000-35 000 zł, zależnie od branży i skali produktu
Polska, B2B, orientacyjne widełki netto plus VAT miesięcznie
- Junior lub early mid: 12 000-18 000 zł
- Mid-level: 20 000-32 000 zł
- Senior: 32 000-48 000 zł
- Lead, Staff, wysoka specjalizacja LLM lub CV: 45 000-70 000 zł+.
USA, orientacyjne roczne widełki base salary
- Entry-level AI lub ML: 85 000-125 000 USD
- Mid-level ML Engineer lub AI Engineer: 125 000-180 000 USD
- Senior AI Engineer lub Applied Scientist: 170 000-240 000 USD
- Staff, Principal, wyspecjalizowane role LLM: 220 000-320 000 USD+
W Stanach dochodzi jeszcze equity, bonus i bardzo duże różnice regionalne. San Francisco, Nowy Jork i Seattle to inna liga niż mniejsze rynki. Z kolei w Europie Zachodniej często zobaczysz niższą pensję nominalną niż w USA, ale wyższy poziom stabilności i bardziej przewidywalne warunki pracy.
Na polskim rynku najlepiej płacą zwykle fintech, cyberbezpieczeństwo, healthtech, duży e-commerce, spółki produktowe SaaS i centra R&D. Nieco niższe stawki częściej pojawiają się w tradycyjnych organizacjach, które dopiero „budują AI”, ale jeszcze nie mają dojrzałej infrastruktury ani sensownego planu wdrożeń.
Jeśli chcesz czytać rynek jak rekruter, patrz także na stawki z konkretnych wakatów, nie tylko na uśrednione tabelki. W praktyce przykładowe ogłoszenia z Polski pokazują dziś mniej więcej takie sygnały: ML Engineer w Warszawie, hybryda 2-3 dni w biurze, często 24 000-32 000 zł B2B; Senior AI Engineer z naciskiem na LLM i RAG, zwykle 30 000-45 000 zł B2B; Data Scientist w bankowości lub retailu, UoP około 18 000-28 000 zł brutto; MLOps lub AI Platform Engineer z Kubernetes i chmurą, często 28 000-40 000 zł B2B; role adoptionowe i Copilotowe w konsultingu albo integratorach, najczęściej 20 000-35 000 zł B2B lub równowartość na UoP.
Warto umieć z tych ogłoszeń wyciągać medianę dla własnej niszy. Jeżeli przejrzysz 15-20 świeżych ofert dla ML Engineerów i tylko 8 z nich podaje stawki, to policz środek przedziału z każdej oferty, a potem medianę. Dla wielu polskich ról AI w 2025 roku taki rynkowy środek wychodzi częściej w okolicach 26 000-32 000 zł B2B dla mid-senior poziomu niż w sensacyjnych kwotach z social mediów. To bardzo użyteczna kotwica negocjacyjna.
Dla kontrastu, vacancy-level compensation w ofertach infrastrukturalnych potrafi zaskoczyć. Role z GPU orchestration, inference serving, OpenShift, NVIDIA i observability bywają wyceniane wyżej niż klasyczny data science, bo kandydatów jest mniej. Jeśli masz dziś 4-6 lat doświadczenia w platform engineeringu i dołożysz do tego AI serving oraz monitoring modeli, możesz wejść w widełki zbliżone do senior LLM engineerów bez siedzenia wyłącznie w NLP.
Praca zdalna w AI, czy nadal jest realna
Tak, ale nie wszędzie i nie dla każdego. Stanowiska AI nadal należą do grupy ról stosunkowo przyjaznych zdalnie, szczególnie jeśli mówimy o software, SaaS, platformach danych i startupach produktowych. Hybryda jest jednak coraz częstsza niż pełen remote, zwłaszcza w większych firmach.
Najłatwiej o pracę zdalną mają zwykle:
- doświadczeni ML Engineerowie i AI Engineerowie
- MLOps Engineerowie
- Data Scientiści pracujący przy produktach cyfrowych
- specjaliści LLM i NLP z udokumentowanym portfolio
- kontraktorzy współpracujący z klientami zagranicznymi
Trudniej bywa w sektorach silnie regulowanych, przy danych wrażliwych albo sprzęcie on-premise, na przykład w części projektów medycznych, przemysłowych czy obronnych. Tu biuro lub praca hybrydowa są częstsze.
Jeśli spojrzeć na rynek miasto po mieście, obraz jest dość spójny. Warszawa daje największy wolumen ofert i najwięcej hybrydy, szczególnie w bankach, konsultingu, SaaS i centrach technologicznych. Kraków ma mocne zapotrzebowanie w korporacjach technologicznych, centrach usług i produktach globalnych. Wrocław regularnie rekrutuje do R&D, embedded, computer vision i infrastruktury. Trójmiasto i Poznań są mniejsze, ale stabilne, zwłaszcza w product tech i data. Katowice oraz szerzej Śląsk pojawiają się częściej w przemyśle, automatyzacji i rozwiązaniach enterprise. Łódź i Lublin mają mniej ofert, ale nie są martwe, szczególnie w outsourcingu i centrach kompetencyjnych.
Tryb pracy też da się czytać po sektorach. Banki i duże korporacje częściej publikują role hybrydowe, zwykle 1-3 dni w biurze. Software house’y i kontrakty międzynarodowe częściej dopuszczają full remote. Projekty z dostępem do środowisk lokalnych, sprzętu przemysłowego albo bardzo restrykcyjnych danych częściej kończą się jako on-site lub mocna hybryda. Jeżeli zależy ci na zdalnej pracy, filtr „remote” to za mało. Szukaj też słów contractor, distributed team, async, EU timezone, Poland remote i B2B.
Jakie technologie i umiejętności najczęściej pojawiają się w ogłoszeniach
Rynek lubi modne hasła, ale zestaw bazowych kompetencji jest zadziwiająco stabilny. Kandydat, który zna fundamenty, wygrywa częściej niż ktoś, kto zna pięć frameworków z ostatnich dwóch miesięcy, ale nie rozumie podstaw.
Najczęściej pojawiające się wymagania techniczne to:
- Python
- SQL
- pandas, NumPy, scikit-learn
- PyTorch lub TensorFlow
- Docker
- Git i praktyka pracy zespołowej
- chmura, najczęściej AWS, Azure lub GCP
- podstawy API i integracji usług
- model evaluation, eksperymenty, monitoring
- statystyka, metryki i rozumienie jakości danych
W rolach generatywnych regularnie wracają też:
- Hugging Face Transformers
- vector databases, np. Pinecone, Weaviate, Qdrant
- RAG i wyszukiwanie semantyczne
- embeddingi
- narzędzia do ewaluacji odpowiedzi modeli
- orkiestracja workflow, np. LangChain lub LlamaIndex
- bezpieczeństwo promptów i kontrola odpowiedzi
Poza technologią liczą się też kompetencje miękkie. Brzmi banalnie, ale w praktyce to właśnie one odróżniają kandydata „spoko technicznie” od osoby, którą zespół naprawdę chce zatrudnić. Najbardziej cenione są: komunikacja, umiejętność tłumaczenia kompromisów, zadawanie dobrych pytań, odpowiedzialność za wynik i zdrowy sceptycyzm wobec własnych modeli.
Warto znać też bardziej szczegółowe sygnały z ogłoszeń, bo one pokazują, gdzie rynek dojrzewa. Dla AI infrastructure coraz częściej liczą się OpenTelemetry, Prometheus, Grafana, Loki, Jaeger, KServe, Seldon, Kubeflow, Ray, vLLM, NVIDIA Triton, OpenShift AI i zarządzanie GPU. Dla ról adopcyjnych przewijają się Microsoft Copilot, Copilot Studio, Power Automate, Azure OpenAI, Purview, SharePoint, Teams i governance danych. Dla Agentic SDLC dochodzą GitHub Copilot, CI/CD, polityki bezpieczeństwa kodu, jakości wygenerowanego kodu i integracje z workflow deweloperskim. Kandydat, który dopasuje CV pod te konkretne słowa kluczowe, zwiększa szansę przejścia ATS i rozmowy z hiring managerem.
Jak wejść do AI, jeśli nie masz jeszcze komercyjnego doświadczenia
Da się. Trzeba tylko odciąć kilka popularnych złudzeń. Nie potrzebujesz doktoratu, żeby zacząć. Nie musisz też mieć dziesięciu certyfikatów. Potrzebujesz dowodów, że umiesz rozwiązywać problemy na danych i pisać kod, który da się ocenić.
Najrozsądniejszy plan wejścia wygląda zwykle tak:
- opanuj Pythona i SQL na poziomie praktycznym
- zbuduj podstawy statystyki i machine learningu
- zrób 3 dobrze opisane projekty zamiast 12 byle jakich
- naucz się czyścić dane, a nie tylko trenować model
- wrzuć kod na GitHuba i dopisz README, instrukcję uruchomienia oraz wyniki
- pokaż wpływ biznesowy, nawet jeśli to projekt własny
- ćwicz opowiadanie o projekcie prostym językiem
Dobry projekt portfolio nie musi być kosmiczny. Może dotyczyć prognozowania churnu w e-commerce, klasyfikacji zgłoszeń supportowych, analizy opinii klientów, OCR dla faktur, wykrywania defektów na zdjęciach albo wyszukiwarki dokumentów z RAG. Ważne, by było widać proces decyzyjny, metryki i ograniczenia.
Jeśli jesteś po backendzie, spróbuj wejść od strony ML engineeringu lub MLOps. Jeśli masz doświadczenie analityczne, naturalna będzie ścieżka data science. Jeśli pracowałeś przy produktach lub procesach biznesowych, sensowna może być specjalizacja w AI Product Management albo AI operations. Nie każdy musi zaczynać od tego samego punktu.
Jeżeli chcesz wejść w nowsze nisze, wybierz jeden tor i zbuduj pod niego portfolio. Dla AI Adoption pokaż plan wdrożenia Copilota w średniej firmie, polityki bezpieczeństwa, metryki adopcji i scenariusze użycia dla 3 działów. Dla Agentic SDLC zbuduj workflow, który generuje testy, analizuje PR i mierzy jakość zmian. Dla AI infrastructure pokaż deployment modelu przez KServe lub Triton, monitoring przez OpenTelemetry i dashboard kosztu oraz opóźnień. Takie portfolio jest bardziej przekonujące niż dziesiąty klon chatbota FAQ.
Co powinno znaleźć się w CV kandydata do AI
CV do ról AI powinno być konkretne i techniczne, ale bez przesady. Lista 40 narzędzi nikogo nie przekona, jeśli nie wiadomo, co realnie z nimi zrobiłeś. Rekruter i hiring manager chcą zobaczyć wpływ, zakres odpowiedzialności i poziom samodzielności.
W dobrym CV warto pokazać:
- technologie użyte w praktyce, nie tylko „znajomość”
- projekty z mierzalnym efektem, np. wzrost trafności o 12% lub skrócenie czasu procesu o 30%
- skalę danych, liczbę użytkowników albo znaczenie biznesowe systemu
- doświadczenie we wdrożeniu, monitoringu i utrzymaniu, jeśli je masz
- publikacje, konkursy, open source lub wystąpienia, jeśli rzeczywiście wzmacniają profil
Nie przesadzaj z sekcją „o mnie”. Dwie, trzy linijki wystarczą. Za to doświadczenie projektowe powinno być opisane tak, by ktoś po drugiej stronie od razu rozumiał, co było problemem, jakiego narzędzia użyłeś i co z tego wynikło.
Przy aktualnym rynku warto też dopisać tryb pracy i lokalizację, jeśli są atutem. Masz zgodę na hybrydę w Warszawie, Krakowie albo Wrocławiu, a do tego akceptujesz kontrakt B2B i pracę po angielsku? Napisz to jasno. Dla wielu firm to realny filtr. W sekcji projektów używaj też nazw technologii, które widzisz w ogłoszeniach: MLflow, Databricks, Azure OpenAI, OpenTelemetry, OpenShift, Copilot Studio, vLLM, KServe. Nie dla ozdoby, tylko tam, gdzie rzeczywiście ich użyłeś.
Jak wygląda rekrutacja do pracy w AI
Procesy różnią się między firmami, ale najczęściej pojawia się podobny schemat. Najpierw rozmowa z rekruterem lub hiring managerem. Potem etap techniczny, czasem w formie live codingu, czasem zadania domowego, a czasem deep dive w poprzednie projekty. Na końcu dochodzi rozmowa z zespołem, menedżerem albo stakeholderami biznesowymi.
W rolach AI możesz spodziewać się pytań o:
- dobór metryk i walidację modeli
- overfitting, data leakage, bias, drift
- przygotowanie danych i feature engineering
- decyzje architektoniczne przy wdrożeniu
- kompromisy między jakością, kosztem i czasem odpowiedzi
- przypadki, w których model nie powinien trafić do produkcji
- współpracę z biznesem i sposób mierzenia wpływu
W rekrutacjach generative AI regularnie padają też pytania o RAG, hallucinations, quality evaluation, prompt design, koszty inferencji, caching, bezpieczeństwo danych i sposoby ograniczania błędnych odpowiedzi. Jeśli kandydujesz na taką rolę, brak tych tematów w przygotowaniu będzie od razu widoczny.
W nowszych kategoriach pytań jest już trochę inny zestaw. W AI Adoption zapytają cię o polityki bezpieczeństwa, pomiar adopcji, use case discovery, szkolenia użytkowników i ryzyka prawne. W Agentic SDLC o jakość wygenerowanego kodu, testy, bezpieczeństwo sekretów, kontrolę uprawnień i wpływ na produktywność zespołu. W AI infrastructure o GPU utilization, autoskalowanie inferencji, observability, SLO, rollout modeli, rollback i koszt serving layer. To nie są pytania z teorii. Rekruterzy sprawdzają, czy umiesz utrzymać system, a nie tylko go uruchomić.
Najczęstsze błędy kandydatów do pracy w AI
Widziałem je wielokrotnie, zarówno po stronie kandydatów, jak i w procesach hiringowych. Powtarzają się zaskakująco często.
Najbardziej typowe wpadki to:
- aplikowanie na zbyt szeroki zestaw ról bez dopasowania CV
- mylenie projektów demo z produkcyjnym doświadczeniem
- brak zrozumienia biznesowego problemu
- zbyt słabe podstawy statystyki i SQL
- opowiadanie o narzędziach zamiast o wynikach
- ignorowanie MLOps, monitoringu i jakości danych
- przecenianie znaczenia certyfikatów
Dodam jeszcze jeden. Kandydaci bardzo często nie czytają ogłoszenia do końca. A potem na rozmowie okazuje się, że firma szukała osoby do wdrażania modeli i pracy z infrastrukturą, a kandydat przygotował się tylko z teorii uczenia nadzorowanego. To drobiazg, który kosztuje ofertę.
Drugi częsty błąd przy obecnym rynku to ignorowanie danych z samych ofert. Jeśli w 12 ogłoszeniach z rzędu widzisz Azure, Databricks i MLflow, a uczysz się wyłącznie egzotycznego frameworka z YouTube, to po prostu źle rozkładasz energię. To samo dotyczy lokalizacji i trybu pracy. Kandydat z Krakowa, który odrzuca hybrydę i celuje wyłącznie w full remote, sam zmniejsza sobie rynek nawet o połowę. Czasem lepiej przyjąć 2 dni w biurze i zdobyć pierwsze sensowne doświadczenie niż czekać miesiącami na ofertę idealną.
Czy warto iść dziś w AI? Tak, ale rozsądnie
Tak, rynek nadal daje bardzo dobre możliwości. Zarówno finansowe, jak i rozwojowe. Nie ma jednak sensu wchodzić do tej branży tylko dlatego, że „teraz jest modna”. Moda nie pomoże ci na rozmowie technicznej, nie uratuje cię przy słabym portfolio i nie zastąpi umiejętności pracy z danymi.
Najlepiej radzą sobie osoby, które traktują AI jak narzędzie do rozwiązywania realnych problemów, a nie jak etykietę do CV. Jeśli zbudujesz mocne podstawy, wybierzesz sensowną specjalizację i nauczysz się pokazywać wartość swojej pracy, masz bardzo realną szansę wejść do tej branży, nawet bez idealnie podręcznikowej ścieżki.
To właśnie jest dobra wiadomość. W AI nadal da się wygrać kompetencją, nie tylko nazwą uczelni czy głośnym tytułem stanowiska.