KI-Jobs sind längst kein Spezialthema mehr für Unis, Forschungslabore oder ein paar Tech-Konzerne in Kalifornien. Heute suchen Unternehmen in Deutschland, Österreich und der Schweiz Fachkräfte für Machine Learning, Datenanalyse, MLOps, Computer Vision, Generative AI und produktnahe KI-Rollen. Banken bauen Betrugserkennung aus, Industriebetriebe optimieren Qualitätskontrolle mit Bildverarbeitung, E-Commerce-Firmen verbessern Empfehlungen, Versicherer automatisieren Dokumentenprozesse, und Mittelständler experimentieren mit internen Assistenten auf Basis großer Sprachmodelle. Wer gezielt nach KI Jobs in Köln sucht, sollte außerdem lokale Suchfilter, konkrete Arbeitgeber und reale Mischprofile kennen, sonst übersieht man schnell passende Stellen, die gar nicht exakt „AI Engineer“ heißen.
Das sorgt für Chancen, aber auch für Verwirrung. Viele Stellen heißen ähnlich, verlangen aber völlig unterschiedliche Profile. Ein „AI Engineer“ schreibt in Firma A produktionsreifen Python-Code und betreibt RAG-Pipelines, in Firma B ist die Rolle fast identisch mit einem Machine-Learning-Engineer, und in Firma C geht es eher um API-Integration und Prototypen. Wer sich blind auf Titel verlässt, bewirbt sich oft an den falschen Stellen.
Noch etwas vorweg: Die meisten Arbeitgeber suchen keine abstrakten „KI-Experten“. Gesucht werden Leute, die ein konkretes Problem lösen. Bessere Prognosen. Schnellere Prozesse. Weniger manuelle Arbeit. Höhere Conversion. Sauberere Daten. Stabilere Modelle im Betrieb. Wer das verstanden hat, hat im Bewerbungsprozess einen Vorsprung.
Was überhaupt als KI-Job gilt
Nicht jede Stelle mit „AI“ im Titel ist hoch technisch. Und nicht jede hoch technische Stelle trägt das Wort „KI“ im Namen. Genau das macht die Suche unnötig kompliziert. Viele gute Rollen laufen unter Data Science, Machine Learning, Data Engineering, Research, Analytics Engineering oder Product.
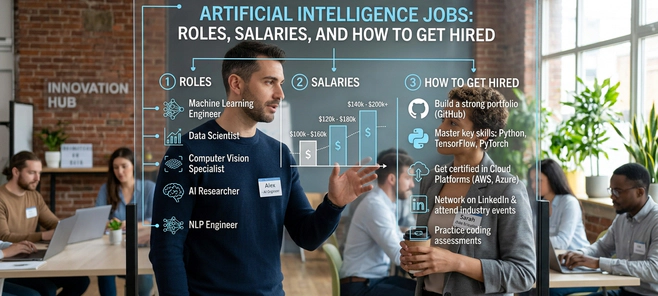
Typische Berufsbezeichnungen im KI-Umfeld sind:
- Machine Learning Engineer
- AI Engineer
- Data Scientist
- Applied Scientist
- Research Scientist
- NLP Engineer oder LLM Engineer
- Computer Vision Engineer
- MLOps Engineer
- AI Product Manager
- Data Engineer mit Fokus auf ML- oder KI-Plattformen
- Prompt Evaluation Analyst oder AI Quality Specialist
- ML Platform Engineer
- KI Trainer, etwa für Datenannotation, Modellbewertung oder Prompt-Qualität
- AI Automation Specialist, zum Beispiel für Workflow-Automatisierung mit LLMs und RPA
- AI Consultant oder AI Builder mit Fokus auf Kundenprojekte, Prototypen und Implementierung
- Administrative oder Support-Rollen mit KI-Fokus, etwa Wissensmanagement, Content Operations oder Tool Enablement
Der Markt wächst weiter, auch wenn der Hype-Zyklus manchmal lauter ist als die Realität. Das deutsche Institut der Wirtschaft, Bitkom, Branchenverbände und zahlreiche Jobportale berichten seit Jahren über einen strukturellen Mangel an IT- und Datenfachkräften. Parallel dazu steigen die Anforderungen. Unternehmen wollen nicht nur Modelle trainieren, sondern Systeme bauen, die zuverlässig laufen, auditierbar sind und echten Nutzen bringen.
Gute KI-Arbeit wirkt im Unternehmen selten spektakulär. Sie spart Zeit, senkt Fehlerquoten, hebt Umsatz oder macht Produkte messbar besser. Genau dafür wird bezahlt.
Die wichtigsten KI-Jobtitel im direkten Vergleich
Viele Kandidatinnen und Kandidaten bewerben sich zu breit, weil die Titel austauschbar klingen. Sind sie nicht. Die Unterschiede liegen im Alltag, im Tech-Stack und im Grad der Verantwortung.
Machine Learning Engineer
Diese Rolle sitzt meist nah an Software Engineering und Infrastruktur. Es geht darum, Modelle nicht nur zu entwickeln, sondern in produktive Systeme zu bringen. Dazu gehören Trainingspipelines, Feature-Verarbeitung, Deployment, Monitoring, Skalierung und Wartbarkeit. Python ist fast immer Pflicht, oft ergänzt durch SQL, Docker, Kubernetes, Spark, Airflow, Git, CI/CD und Cloud-Dienste auf AWS, Azure oder GCP.
Wer aus der klassischen Softwareentwicklung kommt und Spaß an Daten, Modellen und Performance hat, landet hier oft sehr gut. In vielen Firmen ist das die Rolle mit dem höchsten praktischen Nutzen. Nicht glamourös, aber extrem gefragt.
AI Engineer
Der Titel ist seit 2023 deutlich unschärfer geworden. Mal ist er nur ein neues Etikett für ML Engineering, mal geht es vor allem um generative KI. Häufige Aufgaben sind die Integration von Foundation Models, Aufbau von RAG-Systemen, Prompt-Workflows, Evaluationslogik, Guardrails, API-Orchestrierung und die Einbettung von KI-Funktionen in bestehende Produkte.
Hier sollte man Stellenanzeigen wirklich Zeile für Zeile lesen. Fragt die Firma nach PyTorch, Fine-Tuning und Metriken, ist die Rolle technisch tief. Fragt sie nach OpenAI API, LangChain, Vektordatenbanken und schnellem Prototyping, dann ist der Fokus eher produktnah. Beides kann spannend sein, aber es sind unterschiedliche Jobs.
Data Scientist
Data Scientists verbringen in vielen Teams mehr Zeit mit Analyse, Experimenten, Kennzahlen, A/B-Tests und Stakeholder-Kommunikation als mit schwerer Modellforschung. Sie prüfen Hypothesen, segmentieren Kundengruppen, bauen Prognosen, bewerten Maßnahmen und übersetzen Daten in Entscheidungen.
Für Menschen mit Statistik-, BWL-, Mathematik- oder Analytics-Hintergrund ist das oft der beste Einstieg in die KI-Welt. Nicht jede Data-Science-Rolle arbeitet mit Deep Learning. Das ist kein Nachteil. Wer saubere Analysen liefert und Business-Fragen klar beantwortet, ist für Unternehmen oft wertvoller als jemand mit einer halbgaren Demo eines LLM-Agenten.
Applied Scientist
Applied Scientists liegen zwischen Forschung und Produkt. Sie experimentieren tiefer mit Modellen, vergleichen Ansätze, verbessern Qualität und lösen knifflige domänenspezifische Probleme. Typisch sind Rollen bei größeren Tech-Firmen, E-Commerce-Plattformen, Mobility-Unternehmen oder spezialisierten SaaS-Anbietern.
Im Unterschied zum ML Engineer liegt der Fokus stärker auf Modellgüte und Methodik. Im Unterschied zum reinen Research Scientist zählt am Ende trotzdem, dass etwas im Produkt landet. Wer mathematisch stark ist und gleichzeitig Ergebnisse unter Zeitdruck liefern kann, passt hier gut hinein.
Research Scientist
Das ist die akademischste der gängigen KI-Rollen. Viele Arbeitgeber erwarten Promotion, Publikationen auf Konferenzen wie NeurIPS, ICML, ACL oder CVPR, oder zumindest sehr tiefe Forschungserfahrung. Solche Jobs gibt es in Forschungseinrichtungen, Konzernen mit großen AI-Teams, spezialisierten Labs und einigen Deep-Tech-Startups.
Für die meisten Bewerber ist das nicht der naheliegende Einstieg. Wer in diese Richtung will, sollte ehrlich prüfen, ob er wirklich Forschungskarriere meint oder eigentlich spannende angewandte Arbeit im Unternehmen sucht. Beides ist legitim. Nur eben nicht dasselbe.
NLP Engineer, LLM Engineer oder Generative-AI-Engineer
Hier dreht sich alles um Sprachsysteme. Chatbots, interne Wissensassistenten, Dokumentenverarbeitung, semantische Suche, Zusammenfassungen, Klassifikation, Extraktion, Übersetzung, Support-Automatisierung. Gefragt sind meist Python, Transformers, PyTorch, Vektordatenbanken, Evaluationsframeworks, Prompting, Retrieval, Modellbewertung und ein sauberer Blick auf Halluzinationen, Kosten und Datenschutz.
Viele Unternehmen überschätzen, wie schnell sich ein brauchbares LLM-System bauen lässt. Gute Kandidaten fallen genau deshalb auf, weil sie nicht nur einen Demo-Chatbot zeigen, sondern Evaluierung, Quellenanbindung, Fehlerraten, Rate Limits, Sicherheitsaspekte und tatsächliche Nutzerprobleme mitdenken.
Computer Vision Engineer
Computer Vision bleibt ein starker Bereich, gerade im DACH-Raum mit seiner industriellen Basis. Einsatzfelder sind Qualitätsprüfung in der Fertigung, OCR und Dokumentenerkennung, medizinische Bildgebung, Retail-Analysen, autonome Systeme, Sicherheitsanwendungen und Logistik. Typische Tools: OpenCV, PyTorch, TensorFlow, YOLO, Detectron, Segmentierungsmodelle und Bilddatenpipelines.
Das ist ein gutes Feld für Leute, die gern konkret arbeiten. Bilder und Videos liefern oft greifbarere Anwendungsfälle als abstrakte Sprachsysteme. Dafür sind Datenqualität, Annotation und Edge Cases oft brutal aufwendig.
MLOps Engineer
MLOps ist in vielen Unternehmen das Nadelöhr. Modelle zu entwickeln ist eine Sache. Sie versioniert, reproduzierbar, überwacht und skalierbar zu betreiben, ist eine andere. MLOps Engineers kümmern sich um Deployment, Model Registry, Feature Stores, Monitoring, Drift-Erkennung, CI/CD für ML, Governance und Betriebssicherheit.
Diese Rollen bekommen oft weniger Aufmerksamkeit als LLM- oder Research-Jobs, sind aber enorm wertvoll. In der Praxis scheitern viele KI-Initiativen nicht an zu wenig Modellintelligenz, sondern an schwachen Datenprozessen und fehlendem Betriebskonzept.
AI Product Manager
Kein klassischer Coding-Job, aber absolut relevant. AI Product Manager priorisieren Use Cases, übersetzen Kundenprobleme, definieren Erfolgskriterien, arbeiten mit Legal, Design, Engineering und Vertrieb zusammen und verhindern, dass Teams teure Spielereien bauen.
Starke PMs im KI-Bereich verstehen genug Technik, um Risiken und Grenzen einzuschätzen, ohne selbst jeden Prototypen zu schreiben. Gerade in regulierten Branchen ist diese Rolle Gold wert.
KI-Jobs nach Erfahrungslevel
Unternehmen stellen auf Junior-, Mid- und Senior-Level komplett unterschiedlich ein. Wer das ignoriert, verschwendet Monate mit Bewerbungen, die nie realistisch waren.
Einstiegsrollen in der KI
Echte Entry-Level-KI-Jobs gibt es, aber sie sind enger zugeschnitten, als viele hoffen. Häufige Einstiegsrollen sind Junior Data Scientist, Data Analyst mit ML-Bezug, Associate ML Engineer, AI QA Specialist, Prompt Evaluation Analyst, Annotation Operations Specialist oder Software Engineer in einem ML-Plattform-Team.
Typische Erwartungen an Berufseinsteiger sind:
- Solides Python und gutes SQL
- Grundkenntnisse in Statistik, Modellbewertung und Datenbereinigung
- Erfahrung mit pandas, scikit-learn und Notebooks
- Zwei bis vier belastbare Portfolio-Projekte
- Nachweis, dass mit unordentlichen echten Daten gearbeitet wurde
- Saubere Kommunikation von Ergebnissen, Annahmen und Grenzen
Der häufigste Fehler auf Junior-Level ist simpel: zu viel Show, zu wenig Substanz. Ein Wochenendprojekt mit Chat-UI und irgendeiner API reicht selten. Recruiter und Hiring Manager wollen sehen, dass jemand ein Problem sauber strukturiert, Daten vernünftig vorbereitet, eine nachvollziehbare Evaluation baut und Entscheidungen dokumentiert.
Mid-Level-Rollen
Mid-Level heißt meist zwei bis fünf Jahre relevante Erfahrung. Jetzt reicht Assistenz nicht mehr. Unternehmen erwarten, dass Projekte von Anfang bis Ende eigenständig getragen werden. Das umfasst Problemdefinition, Datenauswahl, Methodenwahl, Evaluierung, Deployment und verständliche Kommunikation mit Fachbereichen.
Hier ist das Einstellungsvolumen oft am größten. Firmen wollen Leute, die schnell produktiv werden, ohne direkt Principal- oder Lead-Gehälter aufzurufen. Genau deshalb ist dieser Karriereschritt so wichtig. Wer es auf Mid-Level schafft, baut den eigentlichen Marktwert auf.
Senior-Rollen
Senior beginnt häufig bei fünf bis acht Jahren relevanter Praxis, manchmal früher, manchmal später. Titelinflation gibt es überall. Entscheidend ist nicht, ob auf LinkedIn „Senior“ steht, sondern ob jemand Architekturentscheidungen trifft, andere coacht, Standards verbessert und mit Unsicherheit umgehen kann.
Auf diesem Niveau zahlt sich Branchenwissen stark aus. Ein Senior AI Engineer mit Erfahrung in Medizintechnik, Finanzrisiko, Cybersecurity oder Supply Chain kann deutlich attraktiver sein als ein rein technischer Generalist. Unternehmen kaufen ab einem gewissen Punkt nicht mehr nur Skill, sondern Urteilsvermögen.
Führungsrollen
Ab Director, Head of AI, VP Data & AI oder Chief AI Officer verschiebt sich die Arbeit deutlich. Weniger Einzelmodellierung, mehr Organisationsaufbau. Es geht um Teamstruktur, Budget, Governance, Make-or-Buy-Entscheidungen, Risiko, Vendor-Auswahl, Compliance und die Frage, welche KI-Initiativen wirtschaftlich Sinn ergeben.
Diese Jobs gehen nicht automatisch an die brillantesten Coder. Sie gehen an Menschen, die Technik und Geschäft zusammenbringen, Risiken sauber bewerten und Teams auf Ergebnisse ausrichten.
Gehälter für KI-Jobs in Deutschland, Österreich und der Schweiz
Bei Gehältern herrscht regelmäßig Chaos. Titel überschneiden sich, Boni und Aktienprogramme verzerren Vergleiche, und ein Berliner Startup zahlt anders als ein Konzern in München, Zürich oder Wien. Dazu kommt: Generative-AI-Rollen werden teils aggressiv bepreist, obwohl die Aufgaben fachlich nicht immer tiefer sind als bei klassischen ML-Positionen.
Die folgenden Spannen sind realistische Richtwerte für Grundgehälter im DACH-Markt, basierend auf aktuellen Ausschreibungen, Recruiter-Erfahrungen und markttypischen Angeboten. Es sind keine Garantien. Branche, Stadt, Unternehmensgröße und dein Profil machen einen großen Unterschied.
Deutschland
- Einstieg in Data Science, Analytics mit ML-Bezug oder Junior ML: ca. 45.000 bis 65.000 Euro
- Mid-Level Data Scientist, ML Engineer, AI Engineer: ca. 65.000 bis 95.000 Euro
- Senior ML Engineer, Applied Scientist, Senior MLOps: ca. 90.000 bis 130.000 Euro
- Staff, Principal oder sehr spezialisierte LLM- und Research-Rollen: ca. 120.000 bis 170.000 Euro, in Einzelfällen mehr
- AI Product Manager: ca. 75.000 bis 120.000 Euro, je nach Produktverantwortung und Branche
In Städten wie München, Stuttgart, Frankfurt und Hamburg liegen Gehälter oft höher als in vielen Regionen Ostdeutschlands oder kleineren Standorten. Berlin zahlt je nach Startup oder Scale-up sehr unterschiedlich. Manche junge Firmen locken mit Equity und bleiben beim Fixgehalt eher konservativ, andere zahlen überraschend stark, wenn sie schnell einstellen müssen.
Für die Einordnung einzelner Anzeigen helfen zusätzlich Monats- und Stundenwerte, weil gerade Werkstudentenstellen, Freelance-Mandate, Teilzeitrollen oder befristete Projektjobs selten als Jahresgehalt ausgeschrieben werden. Typische Beispiele aus dem Markt: Werkstudentische KI- oder Data-Rollen liegen oft bei etwa 15 bis 22 Euro pro Stunde, stärker spezialisierte studentische Tech-Rollen in Ballungsräumen teils bei 23 bis 28 Euro. Juniorige Vollzeitstellen mit 48.000 Euro Jahresgehalt entsprechen grob 4.000 Euro brutto pro Monat, 72.000 Euro Jahresgehalt liegen bei rund 6.000 Euro brutto monatlich, 96.000 Euro bei etwa 8.000 Euro. Für Freelancer im Bereich LLM-Prototyping, Automatisierung oder Datenanalyse sieht man je nach Erfahrung grob 60 bis 120 Euro pro Stunde, bei sehr spezialisierten Architekturen oder regulierten Branchen auch darüber.
Österreich
- Einstieg: ca. 40.000 bis 55.000 Euro
- Mid-Level: ca. 55.000 bis 80.000 Euro
- Senior: ca. 80.000 bis 115.000 Euro
- Führungs- oder Spezialrollen: ca. 110.000 bis 150.000 Euro
Gerade in Österreich lohnt sich ein genauer Blick auf kollektivvertragliche Mindestgehälter versus tatsächliche Zielgehälter. Die Spanne zwischen Pflichtangabe in der Anzeige und realem Angebot kann erheblich sein.
Schweiz
- Einstieg: ca. 85.000 bis 110.000 CHF
- Mid-Level: ca. 110.000 bis 145.000 CHF
- Senior: ca. 140.000 bis 190.000 CHF
- Principal, Research oder Lead-Rollen: 180.000 bis 240.000 CHF und darüber
Die Schweiz zahlt stark, aber Lebenshaltung und Sozialkosten muss man fair mitrechnen. Zürich und Zug liegen oft vorn, Basel ist in Pharma und Life Sciences interessant, Lausanne und Genf eher forschungsnah.
Was das Gehalt wirklich nach oben treibt
Nicht der Titel allein, sondern der kombinierte Wert aus Technik, Domäne und Umsetzungsstärke. Besonders gut bezahlt werden oft:
- Kandidaten mit produktionsreifer ML-Erfahrung und starkem Softwareprofil
- Spezialisten für MLOps, Plattformen und Skalierung
- Fachkräfte mit Branchenwissen in Finance, Health, Industrie oder Cybersecurity
- Leute, die LLM-Systeme nicht nur basteln, sondern evaluieren, absichern und wirtschaftlich betreiben können
- Bewerber mit nachweisbarem Business Impact, zum Beispiel Kostenreduktion, Conversion-Uplift oder sinkende Bearbeitungszeiten
Remote-Arbeit und Standorttrends
Viele hoffen auf 100 Prozent remote und internationales Gehalt. Das klappt, aber längst nicht überall. Gerade bei KI-Rollen hängt viel von Datenzugriff, Compliance, Teamstruktur und Seniorität ab. Startups sind oft flexibler, regulierte Unternehmen deutlich strenger. Hybride Modelle mit zwei bis drei Bürotagen sind im DACH-Raum inzwischen sehr verbreitet.
Remote ist außerdem nicht für jede Rolle gleich realistisch. AI Product Management, MLOps und einige Data-Science-Jobs funktionieren gut hybrid oder remote. Rollen mit enger Hardware-Anbindung, sensiblen Daten oder starkem Abstimmungsbedarf, etwa in Medizintechnik oder Industrieproduktion, verlangen häufiger Präsenz.
Wer remote arbeiten will, sollte im Profil drei Dinge klar zeigen: eigenständige Arbeitsweise, starke schriftliche Kommunikation und saubere Dokumentation. Viele Teams stellen lieber jemanden ein, der Ergebnisse präzise festhält, als einen reinen Technik-Crack mit chaotischem Arbeitsstil.
Welche Skills Arbeitgeber heute wirklich erwarten
Die klassische Liste mit Python, SQL und Machine Learning stimmt immer noch. Sie reicht nur oft nicht mehr. Gefragt ist ein Bündel aus technischem Handwerk, Produktdenken und sauberem Arbeiten.
Technische Grundlagen
- Python ist Standard, oft dazu SQL
- Statistik, Experimentdesign und Metriken bleiben Pflicht
- Datenverarbeitung mit pandas, Spark oder ähnlichen Tools
- ML-Bibliotheken wie scikit-learn, XGBoost, PyTorch oder TensorFlow
- Git, Testing, Packaging und lesbarer Code
- Cloud-Grundlagen auf AWS, Azure oder GCP
Für moderne AI-Engineer- und LLM-Rollen
- Retrieval-Augmented Generation, Chunking, Embeddings, Ranking
- Vektordatenbanken und semantische Suche
- Evaluierung von Antwortqualität, Halluzinationen und Kosten
- API-Design, Orchestrierung, Guardrails und Observability
- Datenschutz, Rechtekonzepte und Logging
Für MLOps und produktionsnahe Rollen
- Docker, Kubernetes, CI/CD und Monitoring
- MLflow, Weights & Biases oder ähnliche Tracking-Tools
- Model Registry, Feature Stores, Datenversionierung
- Verlässliche Deployments und Incident-Handling
Unterschätzte Soft Skills
- Ergebnisse für Nicht-Techniker verständlich machen
- Gute Entscheidungen unter unvollständigen Daten treffen
- Annahmen offenlegen und Risiken benennen
- Mit Produkt, Recht, Datenschutz und Fachbereich arbeiten können
- Dokumentieren, priorisieren, sauber abschließen
Genau an diesem Punkt verlieren viele Bewerber den Anschluss. Technisch ordentlich, aber zu wenig greifbar im Business. Unternehmen kaufen selten „Modellwissen“ isoliert. Sie kaufen bessere Entscheidungen und funktionierende Systeme.
So sieht der Bewerbungsprozess für KI-Jobs oft aus
Der Ablauf variiert, folgt aber meist einem bekannten Muster. Wer weiß, was kommt, wirkt automatisch souveräner.
1. Screening durch Recruiting oder Hiring Manager
Hier zählt weniger Detailtiefe als Klarheit. Kannst du in zwei Minuten erklären, was du gebaut hast, warum es relevant war und welches Ergebnis herauskam? Wer sich in Buzzwords verliert, fliegt oft früh raus.
2. Technisches Interview
Je nach Rolle kommen Coding-Fragen, SQL, Statistik, ML-Grundlagen, Systemdesign oder Fragen zu bisherigen Projekten. Für LLM-Rollen sind typische Themen RAG-Architektur, Evaluierung, Prompting, Kostenkontrolle und Sicherheitsprobleme. Für MLOps geht es eher um Deployment, Monitoring und Skalierung.
3. Case Study oder Take-Home
Viele Unternehmen lassen einen Mini-Fall lösen. Gute Firmen stellen dafür ein realistisches Zeitfenster bereit. Schlechte Firmen geben Aufgaben, die fast gratis Beratungsarbeit sind. Ein brauchbares Take-Home testet Denken, Struktur und Kommunikation, nicht 15 Stunden unbezahlte Fleißarbeit.
4. Team- und Stakeholder-Gespräche
Spätestens jetzt wird geprüft, ob du mit Produkt, Fachbereich und Management sprechen kannst. Gerade bei KI-Rollen ist das zentral, weil Wirkung fast immer teamübergreifend entsteht.
5. Abschlussrunde und Angebot
Hier werden Gehalt, Arbeitsmodell, Teamstruktur und manchmal auch ethische oder regulatorische Verantwortung besprochen. Frag ruhig konkret nach Datenzugriff, Produktionsreife, Ownership und Erfolgsmessung. Das zeigt Reife.
Wie du ohne perfekten Lebenslauf trotzdem in KI reinkommst
Nicht jeder braucht einen Master in Machine Learning oder eine Promotion. Viele gute Leute kommen aus Softwareentwicklung, Analytics, Mathematik, Physik, BWL, Linguistik oder Ingenieurwesen. Entscheidend ist, wie glaubwürdig du die Brücke baust.
Der stärkste Weg für Software Engineers
Wenn du schon solide entwickelst, nutze das. Lern Datenpipelines, Modellintegration, Inferenz, Evaluation und Deployment. Firmen suchen händeringend Leute, die KI-Funktionen zuverlässig in Produkte bringen. Oft ist das ein leichterer Einstieg als sofort als „reiner“ Data Scientist wahrgenommen werden zu wollen.
Der stärkste Weg für Analysten und Data Professionals
Bau Statistik, Experimentdesign und Prognosemodelle aus. Zeig, dass du von Dashboarding zu echter Entscheidungsunterstützung kommst. Viele Data Scientists starten genau so.
Der stärkste Weg für Quereinsteiger
Quereinstieg klappt, aber selten über reines Konsumieren von Kursen. Was zählt, sind nachweisbare Ergebnisse. Lieber drei durchdachte Projekte als zwölf Zertifikate. Am besten Projekte mit echtem Datensatz, sauberem Git-Repository, Dokumentation, Fehleranalyse und einem klaren Use Case.
Portfolio: Was wirklich überzeugt
Ein gutes Portfolio ist keine Sammlung zufälliger Notebooks. Es ist ein Beweis dafür, wie du denkst und arbeitest.
Starke Portfolio-Projekte zeigen in der Regel:
- Ein klares Problem mit fachlichem Kontext
- Echte oder realistische Daten
- Nachvollziehbare Methodik statt Tool-Show
- Evaluation mit geeigneten Kennzahlen
- Grenzen, Fehlerquellen und nächste Schritte
- Saubere README, reproduzierbare Struktur und verständlichen Code
Beispiel: Ein Dokumentenklassifizierer für Rechnungen und Verträge ist besser als der hundertste Standard-Titanic-Datensatz. Ein kleines RAG-System für interne Wissensartikel, inklusive Evaluationsmatrix und Kostenbetrachtung, ist stärker als ein generischer Chatbot mit hübscher Oberfläche. Ein Computer-Vision-Projekt zur Fehlererkennung in Produktbildern ist oft überzeugender als ein weiteres Katzen-vs.-Hunde-Beispiel.
Die häufigsten Fehler bei Bewerbungen für KI-Jobs
Hier scheitern auffallend viele eigentlich gute Bewerber.
- Zu starke Fixierung auf Titel statt auf Aufgabenprofil
- Lebensläufe voller Buzzwords ohne messbare Ergebnisse
- Projekte ohne Evaluation, Dokumentation oder Business-Bezug
- Bewerbung auf Senior-Rollen ohne produktive Erfahrung
- Unterschätzung von SQL, Datenqualität und Software-Grundlagen
- Kein klares Narrativ, warum genau diese Rolle passt
- Übertriebene LLM-Begeisterung ohne Verständnis für Grenzen, Datenschutz und Betrieb
Gerade der letzte Punkt fällt derzeit stark auf. Fast jeder behauptet, mit GenAI gearbeitet zu haben. Sehr wenige können sauber erklären, wie sie Qualität gemessen, Halluzinationen begrenzt oder sensible Daten geschützt haben. Wer das glaubwürdig kann, hebt sich sofort ab.
So erhöhst du deine Chancen auf eine Zusage
Eine gute KI-Bewerbung wirkt konkret, nicht wolkig. Sie zeigt nicht nur Skills, sondern Relevanz.
Was in den Lebenslauf gehört
- Konkrete Projekte mit Tech-Stack und Ergebnis
- Metriken, zum Beispiel Zeitersparnis, Genauigkeit, Umsatzbeitrag oder Prozessverkürzung
- Produktionsbezug, falls vorhanden
- Werkzeuge nur nennen, wenn sie wirklich eingesetzt wurden
- Domänenwissen klar ausweisen
Was im Anschreiben oder in der Bewerbungsmail zählt
Kurz sagen, warum genau diese Rolle passt. Keine allgemeine Schwärmerei über KI. Ein Absatz zu relevanten Projekten, ein Absatz zum fachlichen Fit, fertig. Gute Hiring Manager merken innerhalb von 20 Sekunden, ob jemand die Anzeige gelesen hat.
Was im Interview überzeugt
Sprich über Entscheidungen. Warum dieses Modell, warum diese Metrik, warum diese Architektur, was hat nicht funktioniert, was würdest du heute anders machen. Reife zeigt sich nicht in Perfektion, sondern in reflektierter Praxis.
Welche Branchen besonders spannend sind
Nicht nur Big Tech stellt ein. Im deutschsprachigen Raum sind einige Sektoren besonders interessant:
- Industrie und Fertigung, etwa Qualitätskontrolle, Predictive Maintenance, Prozessoptimierung
- Gesundheitswesen und Medizintechnik, etwa Bildauswertung, Dokumentation, Risiko- und Prozessunterstützung
- Finanz- und Versicherungswirtschaft, etwa Betrugserkennung, Risikoanalyse, Automatisierung
- E-Commerce und SaaS, etwa Empfehlungssysteme, Suche, Support-Automatisierung, Pricing
- Logistik und Supply Chain, etwa Forecasting, Routenoptimierung, Kapazitätsplanung
- öffentliche Verwaltung und GovTech, etwa Dokumentenprozesse und Service-Automatisierung
Gerade der Mittelstand wird oft unterschätzt. Dort gibt es weniger Schlagzeilen, aber häufig sehr reale Probleme mit gutem Datenbestand und klarer Wirkung. Wer gern pragmatisch arbeitet, findet hier oft spannendere Aufgaben als in überhitzten Hype-Teams.
Konkreter wird es, wenn man auf Arbeitgeber statt nur auf Branchen schaut. Im DACH-Raum tauchen in KI-Suchen regelmäßig Namen wie Deloitte, Accenture, adesso, Capgemini, IBM, SAP, Siemens, Bosch, Deutsche Telekom, REWE digital, Zalando, Allianz, AXA, Bayer, Roche, AWS, Microsoft, Celonis oder spezialisierte Startups auf. In Köln selbst und im direkten Umland lohnt sich der Blick auf Konzerne, Beratungshäuser, Telekommunikation, Versicherungen, E-Commerce, Medien und öffentliche IT-Dienstleister. Dort sind die Titel oft gemischt, also nicht nur „AI Engineer“, sondern auch Data Scientist, Intelligent Automation Consultant, GenAI Consultant, ML Engineer, Business Analyst mit AI-Fokus oder Product Owner für datengetriebene Produkte.
KI Jobs in Köln: so sieht eine realistische lokale Suche aus
Wer gezielt KI Jobs in Köln sucht, sollte nicht nur nach „KI“ filtern. In der Praxis findet man in Köln und Umgebung häufig Anzeigen unter Begriffen wie „Data Scientist“, „Machine Learning Engineer“, „AI Consultant“, „Automation Specialist“, „Prompt Engineer“, „Analytics Engineer“, „Computer Vision“, „Intelligent Automation“ oder „Generative AI“. Dazu kommen Nachbarstädte wie Bonn, Düsseldorf, Leverkusen und Aachen, die für viele Pendler faktisch zum gleichen Arbeitsmarkt gehören. Ein Radius von 15 Kilometern ist für reine Kölner Innenstadtrollen sinnvoll, 30 bis 50 Kilometer liefert meist deutlich mehr Treffer.
Eine brauchbare lokale Shortlist sieht oft so aus: Beratungen mit AI- oder Automation-Teams, Telekommunikations- und Medienunternehmen mit Datenprodukten, Versicherer mit Dokumenten- und Betrugserkennung, E-Commerce-Player mit Suche und Empfehlungssystemen, sowie IT-Dienstleister mit Kundenprojekten rund um GenAI und Prozessautomatisierung. Gesucht werden dabei nicht nur Seniors. Gerade in Köln tauchen regelmäßig auch Werkstudentenstellen, Praktika, Associate-Rollen, Junior-Consulting-Jobs und Support-nahe Funktionen mit KI-Bezug auf.
Praktisch heißt das für die Suche: Erstelle nicht eine Suche, sondern mindestens fünf. Eine für technische Kernrollen, eine für GenAI und LLM, eine für Beratung und Automatisierung, eine für Analystenrollen mit ML-Bezug und eine für operative KI-Rollen wie Evaluation, Training oder Content Operations. Sonst gehen dir gemischte Ausschreibungen durch, die lokal oft den größten Teil des Markts ausmachen.
Suchfilter, die bei KI-Jobs wirklich Zeit sparen
Die meisten Bewerber filtern zu grob. Besser ist eine systematische Kombination aus sechs Parametern:
- Arbeitsort: Vor Ort, hybrid, remote oder explizit Home Office. Manche Firmen schreiben „hybrid“, meinen aber drei bis vier Präsenztage.
- Distanz: 10, 25 oder 50 Kilometer machen einen riesigen Unterschied, gerade rund um Köln mit Bonn, Düsseldorf und dem Rhein-Erft-Kreis.
- Vertragsart: Vollzeit, Teilzeit, Werkstudent, Praktikum, befristet, unbefristet, Freelancer oder Arbeitnehmerüberlassung.
- Einstiegszielgruppe: Berufseinsteiger, Professional, Senior, Lead, Studierende, Absolventen oder Quereinsteiger.
- Branche oder Business Unit: Beratung, Finance, Health, Industrie, öffentliche Hand, Telekommunikation oder internes Innovationsteam.
- Aktualität: Anzeigen der letzten 24 Stunden, 7 Tage oder 14 Tage. Gerade bei stark gefragten Rollen sinkt die Rückmeldequote nach zwei bis drei Wochen oft deutlich.
Eine simple Taktik funktioniert erstaunlich gut: Filter zuerst nach Veröffentlichungsdatum und Arbeitsmodell, erst danach nach Titel. So landest du bei frischen Anzeigen, die wirklich zu deinem Alltag passen, statt bei alten Karteileichen mit schickem Namen. Für Junioren ist „letzte 7 Tage“ oft besser als „letzte 30 Tage“. Für Spezialisten kann „letzte 30 Tage“ sinnvoll sein, weil Nischenrollen länger offen bleiben.
Beispiele für reale Mischprofile statt Lehrbuchrollen
Der Live-Markt ist unordentlicher als Karriere-Ratgeber. Genau deshalb lohnt ein Blick auf Mischprofile, die Bewerber oft ignorieren:
- KI Trainer für Datenlabeling, Modellfeedback, Prompt-Bewertung oder Antwortqualität
- AI Automation Specialist für interne Prozesse, CRM-Workflows, Dokumentenabläufe und Ticket-Automatisierung
- AI Consultant oder AI Builder in Beratungen und Agenturen mit Kundenfokus
- Intelligent Automation Consultant mit Kombination aus RPA, Process Mining und GenAI
- Wissensmanager, Content Operations Specialist oder Support Manager mit KI-Tool-Verantwortung
- Technische Projektmanager für die Einführung von Copilots, Assistenzsystemen oder Suchlösungen
Für viele Bewerber sind genau diese Rollen der beste Einstieg, weil sie weniger reine Modellentwicklung verlangen, aber trotzdem direkt an KI-Produkten oder KI-Prozessen arbeiten. Wer aus Operations, Support, Beratung oder Fachbereich kommt, sollte sie nicht als Nebenrollen abtun. In manchen Firmen sind sie der schnellste Weg in größere AI-Programme.
Beispiel Arbeitgeber: Deloitte und ähnliche Beratungen
Wer wissen will, wie große Arbeitgeber KI-Karrieren strukturieren, kann sich Beratungshäuser gut anschauen. Deloitte ist dafür ein brauchbares Beispiel, weil dort AI nicht in einem einzigen Team sitzt, sondern quer über Consulting, Risk Advisory, Technology, Data, Cloud und Intelligent Automation verteilt ist. Typische Suchmuster auf Karriereseiten solcher Firmen sind Filter nach Standort, Business Unit, Jobtyp und Zielgruppe, also etwa Studierende, Berufseinsteiger, Professionals oder Führungskräfte. Genau diese Filter sollte man aktiv nutzen, weil sonst viele relevante Stellen in allgemeinen Consulting-Listen verschwinden.
Bei Deloitte und vergleichbaren Häusern laufen KI-nahe Rollen oft unter Bezeichnungen wie AI & Data Consultant, Generative AI Consultant, Data Scientist, Intelligent Automation Consultant, Machine Learning Engineer, AI Governance Specialist oder Technology Consultant mit AI-Schwerpunkt. Programme und Teamnamen wie aiStudio, AI Governance Masterclass oder Einstiegswege in Intelligent Automation zeigen, worauf der Arbeitgeber intern setzt: nicht nur Modellentwicklung, sondern auch Governance, Risiko, Compliance, Prozessautomatisierung und skalierbare Kundenlösungen.
Wer sich dort bewirbt, sollte die Logik verstehen. Ein Profil für aiStudio oder GenAI-Beratung braucht meist mehr Prototyping, Kundenkommunikation und Use-Case-Denken. Ein Profil für AI Governance braucht stärkeres Verständnis für Dokumentation, regulatorische Anforderungen, Modellrisiken, Datenschutz und Kontrollmechanismen. Intelligent-Automation-Einstiegsrollen wiederum passen oft gut zu Bewerbern, die aus Prozessmanagement, Wirtschaftsinformatik, Business Analysis oder Low-Code-Automatisierung kommen.
So prüfst du einen Arbeitgeber über die eigene Jobliste
Eine einzelne attraktive Stelle sagt wenig. Aussagekräftiger ist die komplette offene Jobliste eines Arbeitgebers. Schau dir dabei vier Dinge an:
- Gibt es mehrere KI-nahe Rollen gleichzeitig, etwa Data, Automation, Governance und Product, oder nur eine isolierte Pilotstelle?
- Sind die Standorte gebündelt, zum Beispiel Köln, Düsseldorf, Berlin, München oder remote, oder wirkt die Suche zufällig?
- Werden unterschiedliche Erfahrungsstufen angesprochen, also Praktikum, Associate, Professional und Manager?
- Wiederholen sich Begriffe wie GenAI, Data Platform, Intelligent Automation, AI Governance oder Cloud? Dann ist das meist ein echtes strategisches Feld.
Das ist der schnellste Weg zu einer browsbaren Sicht auf aktuelle Vakanzen bei einem Arbeitgeber, ohne sich von einer einzigen Anzeige blenden zu lassen. Wenn ein Unternehmen zehn relevante Rollen offen hat, davon drei in deiner Region und zwei auf deinem Level, ist das oft ein besseres Signal als eine vermeintliche Traumstelle bei einem Arbeitgeber ohne sichtbares AI-Setup.
Fazit
KI-Jobs bieten hervorragende Chancen, aber nur für Bewerber, die genauer hinschauen als der Durchschnitt. Der Markt belohnt nicht die lauteste Selbstvermarktung, sondern spürbaren Nutzen. Wer den Unterschied zwischen Data Science, ML Engineering, MLOps, Generative AI und produktnahen Rollen versteht, spart Zeit und zielt viel präziser.
Wenn du in dieses Feld willst, konzentrier dich auf drei Dinge: erstens ein klares Zielprofil, zweitens belastbare Projekte oder Erfahrung, drittens die Fähigkeit, technische Arbeit in Geschäftswert zu übersetzen. Für lokale Märkte wie Köln kommt noch ein vierter Punkt dazu, nämlich saubere Suchlogik mit Radius, Home-Office-Filter, Vertragsart, Zielgruppe und frischen Anzeigen. Dann steigen die Chancen erheblich, egal ob du am Anfang stehst, aus einem Nachbarbereich kommst oder den nächsten Karriereschritt in Richtung Senior oder Lead suchst.
Der KI-Arbeitsmarkt ist kein Selbstläufer. Aber er ist deutlich zugänglicher, als viele glauben, wenn man die Rollen sauber trennt, konkrete Arbeitgeber beobachtet und den eigenen Fit ehrlich aufbaut.